Серверы Supermicro и сеть Cisco: как спланировать инфраструктуру для виртуализации
Кластер виртуализации объединяет несколько физических серверов, чтобы запускать виртуальные машины, переносить их между узлами и восстанавливать работу после предусмотренных проектом отказов. Официальный поставщик Supermicro предоставляет вычислительные ресурсы, память и дисковые подсистемы, а сеть Cisco связывает хосты, хранилища, пользователей и средства управления. Результат зависит от согласованности всей цепочки: быстрые процессоры не компенсируют перегруженный канал к СХД, а два коммутатора не обеспечат резервирование, если оба подключены к одной линии питания.
Ниже — порядок проектирования инфраструктуры: от списка приложений и требований к простою до общей спецификации и испытаний. Разберём пример трёх узлов, расчёт N+1, разделение трафика, выбор между внешней СХД и распределённым хранением, а также вопросы, которые стоит закрыть до заказа оборудования.
Как спланировать кластер виртуализации: короткий ответ
Сначала определите, какие приложения должны продолжать работать при отказе узла, затем рассчитайте ресурсы оставшейся инфраструктуры. Для каждого сервиса нужны допустимый простой, допустимая потеря данных, требования к CPU и RAM, объём и характер дисковых операций. Только после этого выбирают число серверов, архитектуру хранения и скорость сети.
- Соберите профиль действующих ВМ и ожидаемый рост нагрузки. Отдельно выделите базы данных, терминальные сервисы и системы с жёсткими требованиями к задержке.
- Выберите модель хранения: внешняя СХД, распределённое хранилище на узлах или локальные диски с репликацией по расписанию.
- Проверьте, помещается ли защищаемая нагрузка в кластер после потери самого крупного узла.
- Спроектируйте независимые пути подключения к сети и хранению, доступ к управлению и питание.
- Согласуйте точные модели, ревизии, лицензии, прошивки и поддержку гипервизора.
- Примите систему по результатам испытаний под нагрузкой, включая отказ оборудования и восстановление из резервной копии.
Конфигурация «три сервера и два коммутатора» сама по себе ничего не говорит о числе поддерживаемых ВМ, скорости приложений или времени восстановления. Эти параметры появляются в проекте вместе с измерениями и проверяемыми критериями.
С чего начать: сколько ВМ, какой простой и какая потеря данных допустимы?
Подготовьте инвентаризацию виртуальных машин. Для каждой запишите назначенные vCPU и память, фактическую загрузку CPU, рабочий объём RAM, размер дисков, IOPS, задержку и сетевые пики. Полезно наблюдать хотя бы полный рабочий цикл компании: обычные дни, отчётность, ночные задания и резервное копирование. Если месячное закрытие создаёт отдельный максимум, недельная статистика его не покажет.
Средняя загрузка за сутки скрывает короткие перегрузки. Сравнивайте её с пиковыми интервалами и высокими процентилями, например p95 и p99. Если p99 задержки диска равен 25 мс, это означает, что 99% измеренных значений не превышают 25 мс; остальные могут быть выше. Для базы данных такой хвост иногда важнее средней скорости последовательного чтения.
| Что фиксировать | Пример требования | На какое решение влияет |
|---|---|---|
| RTO: время восстановления | Работа приложения должна восстановиться за 15 минут | HA, порядок запуска ВМ, автоматизация, доступность зависимостей |
| RPO: допустимая потеря данных | Не более 15 минут изменений | Частота копий и репликации, защита журналов приложения |
| Нагрузка на хранение | Пиковые IOPS, блок, доля записи и допустимая задержка | SSD, контроллеры, СХД, сеть, политика размещения данных |
| Окно обслуживания | Один хост можно вывести на обновление без остановки остальных | Запас CPU/RAM, миграция, совместимость процессоров |
| Горизонт роста | Рост защищаемой нагрузки на 25% за выбранный период | Размер узлов, свободные порты, диски и лицензии |
Числа в этой таблице — примеры формулировок для ТЗ. RTO 15 минут не следует автоматически из наличия HA: в него должны поместиться обнаружение отказа, перезапуск ВМ, восстановление базы и проверка приложения. RPO 15 минут тоже требует измерения, а не только задания интервала резервного копирования.
Внешняя СХД или гиперконвергенция: что выбрать для Supermicro?
При внешней СХД вычислительные узлы используют общее хранилище по поддерживаемому протоколу: например, iSCSI или NFS через Ethernet либо Fibre Channel через отдельную SAN. CPU и память хостов в основном обслуживают ВМ, а дисковая производительность и ёмкость масштабируются в контуре хранения. Однако СХД, её контроллеры, сетевые порты и пути подключения становятся частью общей схемы отказоустойчивости.
В гиперконвергентной архитектуре узлы одновременно запускают ВМ и хранят распределённые данные. Так работают, в частности, связки Proxmox VE с Ceph и некоторые конфигурации vSAN. Репликация, восстановление копий и балансировка используют CPU, RAM, диски и сеть тех же серверов. Поэтому проект HCI нельзя получить простым переносом спецификации вычислительных хостов с внешней СХД.
Локальное хранилище с периодической репликацией — ещё один вариант. Оно может быть оправдано для небольшого проекта, но между копиями остаётся интервал потери данных. Наличие реплики не означает, что любая ВМ автоматически перезапустится без потери последних изменений.
| Архитектура | Что удобно | Что обязательно рассчитать |
|---|---|---|
| Хосты и внешняя СХД | Раздельное расширение вычислений и хранения | Контроллеры, пути, поддержка протокола, отказ порта и производительность СХД после отказа |
| HCI с распределённым хранением | Общее управление вычислениями и дисками, расширение узлами | Реплики, домены отказа, ресурсы хранения на хостах, трафик восстановления |
| Локальные диски и репликация | Простая аппаратная основа небольшого проекта | RPO, размещение актуальной копии, порядок переключения и возврата |
Для внешнего хранения имеет смысл заранее сопоставить системы хранения Supermicro с выбранным гипервизором и протоколом. Важно различать законченную СХД с нужными функциями и дисковую полку JBOD: сама полка не предоставляет кластеру контроллеры, общий файловый сервис и автоматическое переключение.
Сколько серверов нужно для отказоустойчивого кластера: два, три или четыре?
Один сервер может запускать множество ВМ, но его аппаратный отказ остановит их одновременно. Два вычислительных узла позволяют построить компактный кластер, если архитектура гипервизора и хранения поддерживает такой вариант. При этом заранее решают вопрос кворума или свидетеля, сетевого разделения и ресурсов одного оставшегося узла.
Три узла упрощают построение кворума в распространённых кластерных схемах. В Proxmox VE три узла дают основу для надёжного кворума, а для двухузлового варианта может применяться внешний QDevice. Он предоставляет дополнительный голос. QDevice не добавляет процессорные ядра, память, дисковую ёмкость и третью копию данных. Размещать его следует с учётом независимости от тех отказов, от которых он защищает.
Четвёртый узел может понадобиться раньше, чем закончится суммарная память: например, для обслуживания одного хоста при уже отказавшем другом, для восстановления реплик на другом домене отказа или для снижения доли ресурсов, теряемых с одним сервером. Это отдельный сценарий N+2, который нужно рассчитать, а не подразумевать под общим словом «резерв».
Число узлов вычислительного кластера, число голосов кворума и число независимых мест хранения данных — три разные характеристики. В проекте их записывают отдельно. Для Ceph дополнительно проверяют размещение мониторов и OSD, политику пула и поведение при отказе целого хоста.
Как рассчитать RAM и запас N+1: пример трёх серверов
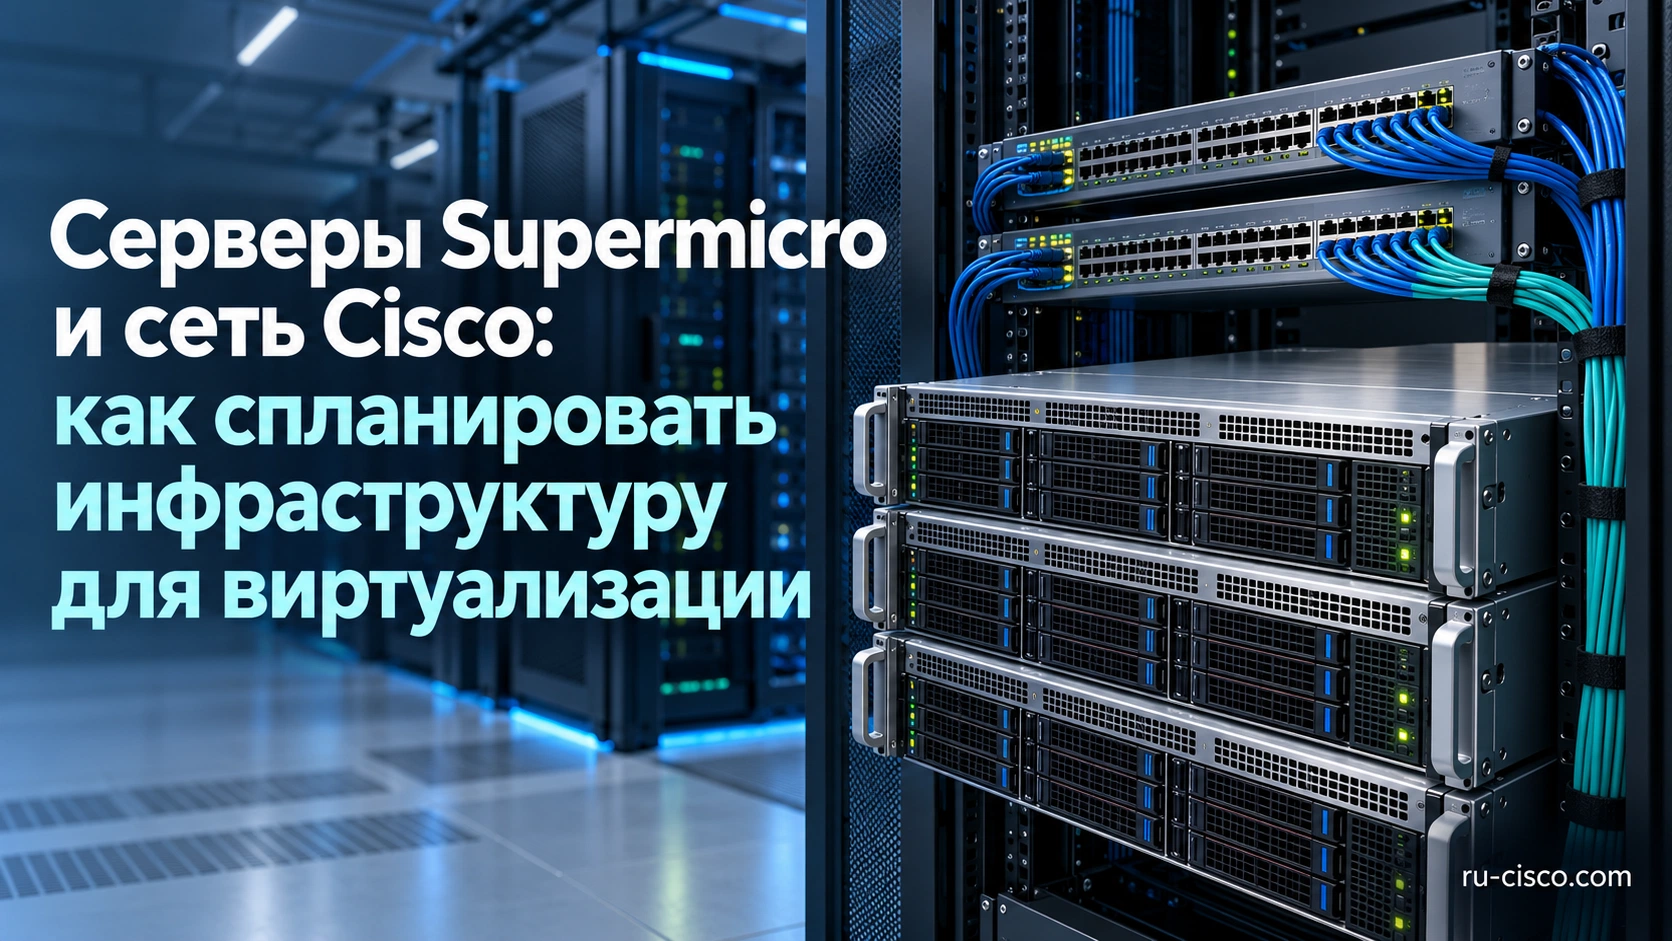
Рассмотрим условный проект с внешней отказоустойчивой СХД. Защищаемым ВМ требуется 900 ГиБ памяти. На выбранный горизонт планирования закладывают рост 25%: получается 1125 ГиБ. Для гипервизора и служебных компонентов в расчёте оставляют по 64 ГиБ на узел. Это принятый запас примера, а не обязательная норма для любого гипервизора.
Установим три одинаковых сервера по 768 ГиБ RAM. Номинально это 2304 ГиБ, но после потери одного хоста остаются два. Для ВМ доступно 2 × (768 − 64) = 1408 ГиБ. После размещения нагрузки с ростом остаётся 1408 − 1125 = 283 ГиБ. Нужно ещё проверить, что отдельные крупные ВМ и ограничения размещения позволяют использовать этот суммарный ресурс.
| Показатель | 3 × 512 ГиБ | 3 × 768 ГиБ |
|---|---|---|
| Установленная RAM всего | 1536 ГиБ | 2304 ГиБ |
| RAM для ВМ после отказа узла, при резерве 64 ГиБ на оставшийся хост | 896 ГиБ | 1408 ГиБ |
| Потребность с ростом 25% | 1125 ГиБ | 1125 ГиБ |
| Разница между ресурсом и потребностью | −229 ГиБ: проект не проходит | +283 ГиБ: проходит по сумме памяти |
Общая формула для одинаковых узлов: RAM для ВМ после отказа одного хоста = (число узлов − 1) × (RAM узла − служебный резерв узла). Для разных серверов из суммы доступных ресурсов вычитают ресурс самого крупного хоста. Затем проверяют правила affinity/anti-affinity, размеры ВМ и ресурсы в каждом фактическом сценарии.
Не включайте ballooning, swap и компрессию памяти в гарантированный резерв без испытаний приложений. Для HCI расчёт нужно повторить с расходом памяти на хранение, в том числе при восстановлении. Проверяйте и схему DIMM: одинаковая ёмкость, собранная разным числом модулей, может давать разную пропускную способность памяти и оставлять разный запас расширения.
Как оценить CPU, NUMA и совместимость процессоров?
Назначенные vCPU не равны постоянно занятым физическим ядрам. ВМ с восемью vCPU может большую часть времени использовать один поток, а другая с четырьмя — непрерывно нагружать все четыре. Коэффициент переподписки vCPU:pCPU подбирают по реальной конкуренции за CPU, задержкам планировщика и требованиям приложений. Универсального безопасного коэффициента для всех баз данных и офисных сервисов нет.
Для предварительной проверки возьмём три узла по 32 физических ядра суммарно в каждом. После отказа одного остаются 64 ядра. Если в проекте выбран целевой предел загрузки 65%, плановый бюджет составляет 41,6 условно полностью занятых ядра на процессорах выбранной производительности. Нагрузка, эквивалентная 30 таким ядрам, с ростом 25% потребует 37,5. Такой расчёт показывает запас, но не заменяет тест: ядра разных поколений и частот нельзя считать одинаковыми.
Крупные ВМ проверяют отдельно с учётом NUMA — неодинаковой задержки доступа к памяти разных процессорных доменов. Суммарной RAM может хватать, но неудачное размещение большой ВМ увеличит межпроцессорный обмен. Заполнение каналов памяти, виртуальная NUMA-топология и настройки гипервизора должны соответствовать профилю приложения.
Если нужна живая миграция, согласуйте процессорный базис до закупки. EVC в VMware не делает Intel и AMD совместимыми для vMotion. В Hyper-V режим совместимости тоже не превращает миграцию между разными производителями CPU в поддерживаемую. Для перехода между такими платформами предусматривают другой сценарий переноса, обычно с выключением ВМ, и проверяют гостевую ОС и приложения.
Как рассчитать хранилище: полезная ёмкость, IOPS и время восстановления
Начните с трёх отдельных значений: полезный объём данных, профиль операций и ожидаемая задержка. Размер накопителей в терабайтах отвечает только на первый вопрос, и то после учёта защиты данных, служебного пространства и эксплуатационного резерва. Для дисковой нагрузки запишите размер блока, случайный или последовательный доступ, долю чтения/записи и число параллельных запросов.
Например, 100 000 операций в секунду блоками по 8 КиБ дают 819 200 000 байт/с, то есть около 0,819 ГБ/с или 6,55 Гбит/с полезных данных. Здесь ещё нет сетевых накладных расходов, репликации и фонового восстановления. Поэтому перевод «IOPS в гигабиты» годится для проверки порядка величины, но не даёт готовую спецификацию канала или массива.
Покажем расчёт ёмкости для другого, условного HCI-примера: 24 SSD по 3,84 ТБ дают 92,16 ТБ сырого пространства. При трёх полных копиях теоретический объём до прочих вычетов равен 30,72 ТБ. Если проектом дополнительно оставлено 30% эксплуатационного резерва, для размещения данных остаётся 21,504 ТБ до учёта метаданных и других особенностей реализации. Это десятичные ТБ; интерфейс в ТиБ покажет другое число.
Свободное место не заменяет домен отказа. Если три копии распределены по трём хостам и один хост потерян, на двух оставшихся невозможно снова разместить три копии на трёх разных хостах. Понадобится вернуть узел или добавить подходящий домен размещения. Возможность продолжать запись определяется также настройками пула и числом доступных копий.
При выборе SSD оценивают ресурс записи, защиту от потери питания, задержку устойчивой записи и поведение после длительной нагрузки. Для Ceph и других программных хранилищ согласуют режим контроллера и прямой доступ к дискам; не добавляют аппаратный RAID автоматически. Два SSD одинаковой ёмкости могут очень по-разному вести себя в задачах с синхронной записью.
Какая сеть нужна для виртуализации: 10, 25 или 100 Гбит/с?
Скорость выбирают по одновременной нагрузке в конкретном месте сети. Для хоста это трафик ВМ, обращений к хранилищу, миграций, репликации и копирования. Для uplink — сумма потоков, которые действительно проходят через него. Обмен между соседними серверами одной стойки может не выходить в ядро, а удалённый репозиторий резервных копий, наоборот, нагружает межсетевое соединение.
10GbE может хватать небольшому кластеру с умеренной дисковой нагрузкой и разнесёнными по времени заданиями. 25GbE стоит рассматривать при плотной виртуализации, быстрых SSD/NVMe, частых миграциях и распределённом хранении. 100GbE может потребоваться для объединения стоек, высокой концентрации потоков или самих серверов с соответствующим профилем ввода-вывода. Ни одна скорость не является обязательной только из-за названия гипервизора.
| Скорость линии | Теоретическая скорость в байтах | Перенос 256 ГиБ за один проход, без накладных расходов |
|---|---|---|
| 10 Гбит/с | 1,25 ГБ/с | Около 220 секунд |
| 25 Гбит/с | 3,125 ГБ/с | Около 88 секунд |
| 100 Гбит/с | 12,5 ГБ/с | Около 22 секунд |
Таблица показывает нижнюю оценку времени простой передачи фиксированного объёма. Живая миграция ВМ сложнее: страницы памяти меняются во время переноса, часть данных пересылается повторно, а доступная полоса делится с другими задачами. При высокой скорости изменения памяти миграция может не укладываться в ожидаемое окно даже при достаточной средней загрузке сети.
Для Ceph выделяют полосу под клиентские операции, репликацию и восстановление. Сеть, которая едва справляется со штатной записью, создаёт проблемы после отказа SSD или узла. Практический подбор интерфейсов и моделей разобран отдельно в материале как выбрать Cisco для серверов, NAS и СХД; здесь главный критерий — прохождение всего кластерного сценария.
Какие сети и VLAN выделить для ВМ, хранения, миграции и IPMI?
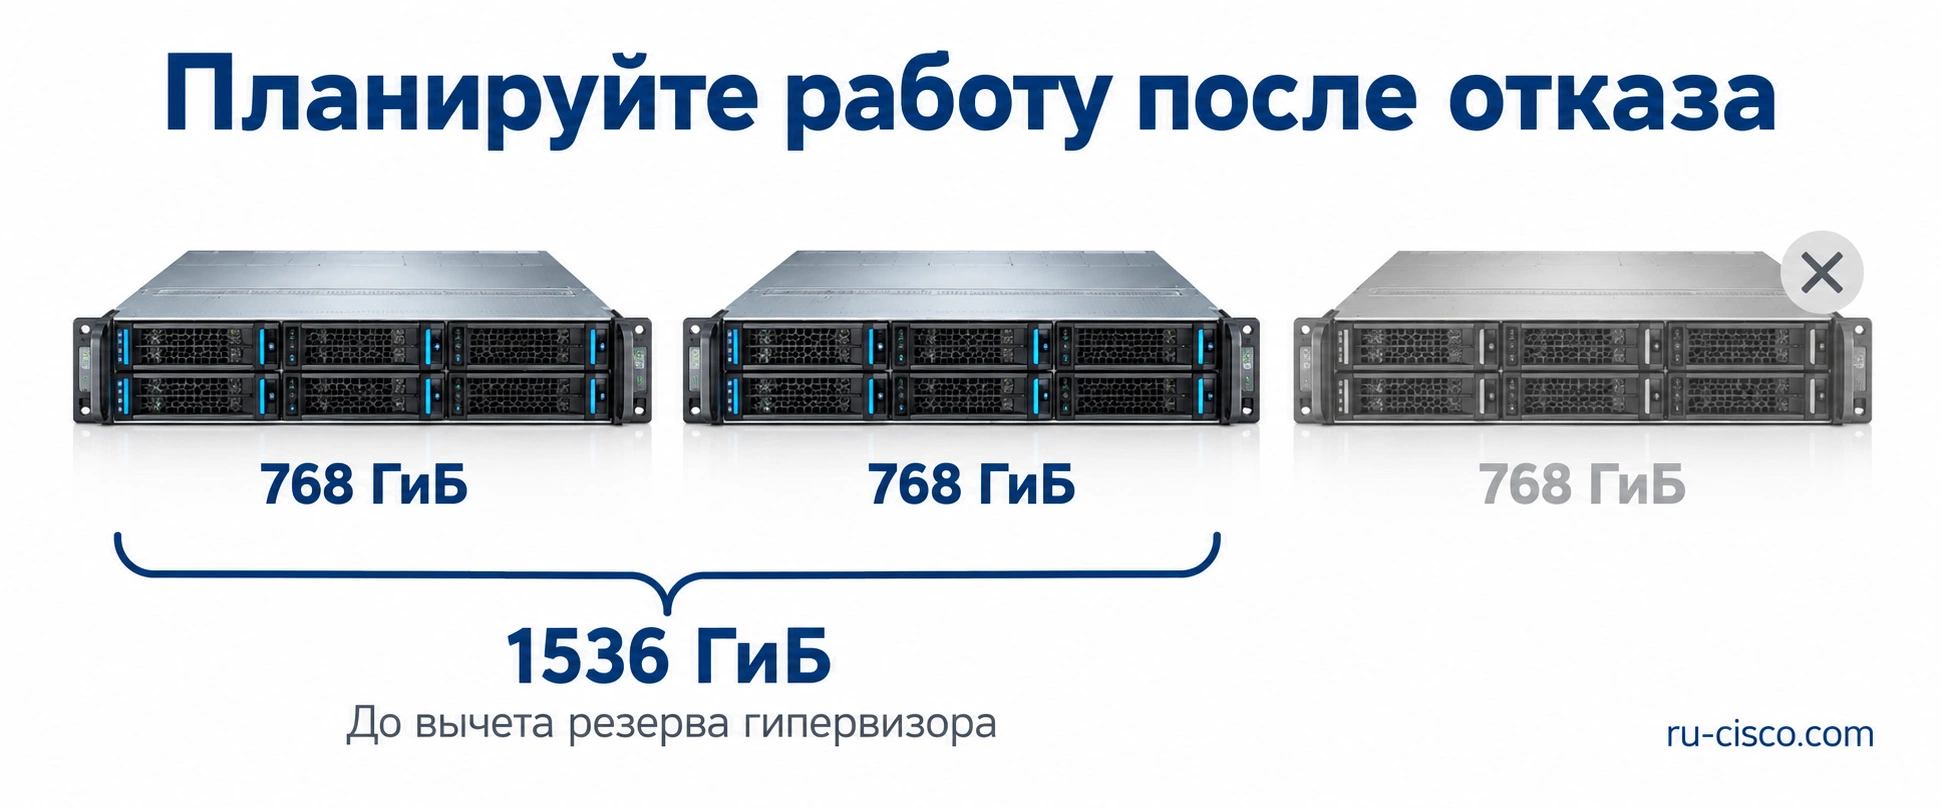
Разделите трафик по назначению и требованиям. Пользовательская ВМ, служебный интерфейс гипервизора, BMC сервера и синхронная запись в хранилище не должны автоматически попадать в один доступный всем сегмент. При этом VLAN обеспечивает логическое разделение, но не резервирует физическую полосу и не заменяет правила доступа.
| Сегмент | Пример VLAN | Что предусмотреть |
|---|---|---|
| Управление гипервизорами | 110 | Доступ администраторов через контролируемый контур, DNS/NTP, журналирование |
| Сети виртуальных машин | 120 и другие по ролям | Разделение приложений и клиентов, маршрутизация и фильтрация между сегментами |
| Хранение, пути A и B | 130 / 140 | Раздельные подсети там, где это требует схема multipathing; доступ только нужных узлов |
| Живая миграция | 150 | Нужная полоса и защита миграционного трафика средствами выбранной платформы |
| Резервное копирование | 160 | Окно копирования, ограничения скорости, отдельные права доступа к репозиторию |
| Кластерный обмен | 170 / 180 | Независимые пути и стабильная малая задержка, без конкуренции с тяжёлым восстановлением |
| BMC / IPMI | 190 | Отдельный административный доступ, изоляция от пользовательских ВМ и интернета |
Номера условные: переносить их поверх существующей адресации без проверки нельзя. Для Proxmox Corosync особенно чувствителен к задержкам. Отдельный гигабитный интерфейс часто достаточен по полосе, тогда как общий быстрый канал, забитый восстановлением Ceph, может нарушить кластерный обмен. Важны независимость путей и задержка под нагрузкой.
Хранение и миграцию не обязательно физически разделять в каждом небольшом проекте. Однако при общей сети нужно доказать, что приоритеты, ограничения скорости и оставшаяся после отказа полоса обеспечивают требуемое поведение. Наличие восьми VLAN поверх двух портов не превращает их в восемь независимых сетей.
Как подключить серверы к двум Cisco: LACP, vPC или отдельные пути?
Для каждого хоста продумайте отказ порта, кабеля, сетевой карты и целого коммутатора. Два порта на одной плате защищают от некоторых проблем соединения, но потеря самой платы отключит оба. Если этот отказ входит в ТЗ, пути A и B разводят по разным адаптерам и проверяют распределение по PCIe и процессорным ресурсам платформы.
Вариант с независимыми uplink и переключением средствами гипервизора не требует автоматически объединять физические порты в LACP. Для сети хранения может использоваться multipathing — несколько отдельных путей, которыми управляет программный стек хранения. Для NFS, iSCSI и других протоколов правила различаются; применять к ним одну схему объединения без проверки нельзя.
LACP создаёт агрегированный канал, а Cisco vPC позволяет поддерживаемому downstream-устройству видеть подключения к двум Nexus как один port-channel. Но vPC не является обязательным условием работы Supermicro и не настраивает гипервизор сам. Требуются согласованные режимы на обеих сторонах, peer-link, контроль доступности peer и проверка сценариев разделения пары.
Два порта по 25 Гбит/с не гарантируют 50 Гбит/с одному TCP-потоку. В типичной схеме хеширования поток выбирает один физический участник агрегата. Несколько потоков могут распределиться между линиями, а после отказа останется меньше суммарной полосы. Если приложению нужны несколько параллельных путей, проверяют поддержку и настройки соответствующего протокола, а не только статус LACP.
Узел с двумя коммутаторами доступа всё ещё зависит от маршрута к пользователям и удалённым сервисам. Проектирование верхнего уровня вынесено в руководство по резервированию ядра сети Cisco. Для серверного проекта достаточно согласовать границы ответственности и поведение uplink при отказе.
Как проверить полосу после отказа и при одновременных заданиях?
Рассмотрим отдельный пример общего физического пути. В одном направлении приложениями и хранением используется 8 Гбит/с, миграцией — 6 Гбит/с, копированием — 4 Гбит/с. Одновременная полезная нагрузка равна 18 Гбит/с. Если проектировщик принимает эксплуатационный предел 70% скорости линии, для 25GbE это 17,5 Гбит/с ещё до подробного учёта накладных расходов.
При таком критерии единственный оставшийся 25G-путь не проходит. Возможные решения: физически разделить часть потоков, уменьшить параллелизм миграций, перенести или ограничить копирование, увеличить скорость линии. Выбор зависит от допустимого времени обслуживания. Запретить бэкап на весь период отказа может быть неприемлемо из-за RPO.
Предел 70% здесь — условие примера, а не стандарт Ethernet. В реальной сети оценивают распределение пакетов, очереди, микровсплески, потери и задержки. Усреднение по пяти минутам может скрыть переполнение выходной очереди длительностью несколько миллисекунд.
Суммируйте только потоки, конкурирующие в одном направлении одного соединения. Ethernet full-duplex позволяет одновременно передавать и принимать данные; складывать независимые входящий и исходящий потоки и сравнивать сумму с односторонней скоростью некорректно. Также учитывайте размещение ВМ: перенос двух активно обменивающихся приложений на разные хосты меняет сетевой профиль.
Как проверить совместимость NIC, SFP28, DAC, прошивок и гипервизора?
Совместимость проверяют по цепочке: серверная платформа → слот и адаптер → firmware и драйвер → гипервизор → кабель или оптика → порт Cisco и версия его ПО. Совпадение разъёма SFP28 не подтверждает все звенья. Важны поддерживаемые скорости, FEC, длина соединения, тип среды и квалификация модулей на обоих концах.
- Платформа Supermicro: точный артикул, ревизия платы, BIOS/BMC, число установленных CPU, доступность нужного PCIe или AIOM-слота и ограничения по охлаждению адаптера.
- Гипервизор: версия и обновление, поддержка системы и компонентов, согласованная пара драйвер/firmware для NIC и контроллеров хранения.
- Cisco: точная модель, режим работы, поддерживаемая версия ПО, лицензируемые функции и включённые порты.
- Соединение: конкретные part number кабелей и модулей, их длина, согласование скорости/FEC и доступность диагностических параметров.
Для коротких соединений в стойке сравнивают DAC и оптику, но выбирают конкретные поддерживаемые изделия. Переход с 10G на 25G нельзя свести к замене наклейки: прежний модуль SFP+ не начинает передавать 25 Гбит/с только потому, что установлен в порт SFP28. Подробный подбор среды вынесен в руководство по SFP и SFP+ для Cisco.
MTU согласуют на всём пути, включая виртуальные коммутаторы и интерфейсы хранения. Для выбранного jumbo MTU проверяют доставку пакетов нужного размера без фрагментации и счётчики ошибок. Значения MTU на конечном IP-интерфейсе и допустимого размера кадра на коммутаторе могут различаться: их нельзя механически приравнивать без учёта терминологии платформы.
RoCE требует отдельного проектирования управления перегрузкой и приоритетами, а иногда PFC/DCB в зависимости от решения. Включать lossless-настройки на всех VLAN «для ускорения виртуализации» не следует. Для обычных TCP-сетей хранения и миграции это не универсальное требование.
Какие серверы Supermicro и коммутаторы Cisco включить в проект?
Выбирать стоит платформы, у которых есть нужный баланс памяти, PCIe, дисковых отсеков и сетевых интерфейсов. Число U в стойке вторично: 1U может быть удобен по плотности, а 2U — по расширению и охлаждению, но реальную комплектацию проверяют для конкретной модели. У многосерверного шасси отдельно оценивают общие компоненты: несколько узлов в одном корпусе могут иметь общий домен отказа.
| Пример платформы | Проверяемые аппаратные особенности | Что это означает для проекта |
|---|---|---|
| Supermicro SYS-621H-TN12R | 2U, два Intel Xeon Scalable 4-го/5-го поколения, 32 DIMM-слота, до двух AIOM-слотов в соответствующей комплектации | Можно сравнивать схемы заполнения памяти и установки NIC; опции и доступность слотов уточняют в выбранной сборке |
| Supermicro AS-2025HS-TNR | 2U, два AMD EPYC 9004/9005, 24 DIMM-слота, сетевое расширение AIOM; для EPYC 9005 нужна плата ревизии 2.x | Подбирают CPU, DIMM и адаптеры под нагрузку; поддержку конкретного процессора проверяют также по BIOS |
| Cisco N9K-C93180YC-FX3 | 48 портов 1/10/25G SFP28 и 6 портов 40/100G QSFP28 | Портовую ёмкость сопоставляют с ростом, peer-link и uplink; режим ПО, оптику и лицензии проверяют отдельно |
Это примеры аппаратной основы для сравнения, а не утверждение, что любая их комбинация является готовым сертифицированным решением. Поддержка определённого гипервизора, vSAN-профиля или сетевой функции относится к точной конфигурации и версии. Если проект строится на ReadyNode, произвольная замена NIC или накопителей может изменить его статус поддержки.
Серверную часть можно начать подбирать в разделе стоечных серверов Supermicro 2U, сетевую — в каталоге Cisco Nexus 9000. Для конкретизации сетевой спецификации пригодится карточка N9K-C93180YC-FX3. Сравнивайте полный состав поставки, а не только базовое название платформы.
Что включить в общую спецификацию трёхузлового кластера?
Для примера с внешней СХД рассмотрим три вычислительных узла по 768 ГиБ и два коммутатора Cisco. На каждом хосте предусмотрены четыре 25G-подключения: по одному пути A/B для трафика ВМ и по одному A/B для хранения. Это один из вариантов физического разделения; он не является минимальным требованием ко всем проектам.
Если используются две двухпортовые карты, распределите роли так, чтобы отказ любой одной карты оставлял и рабочую сеть ВМ, и путь к хранению. Например, первая NIC обслуживает пути A обоих контуров, вторая — пути B. Саму возможность такой установки проверяют по платформе, riser, PCIe и распределению линий.
| Позиция | Количество в примере | Что не пропустить |
|---|---|---|
| Вычислительные хосты | 3 | CPU, 768 ГиБ RAM, системные диски, NIC, рельсы, совместимые прошивки |
| 25G-подключения хостов | 12 линий: по 4 на хост, по 6 к каждому Cisco | Оптика или DAC, маркировка, длина, поддержка на обоих концах |
| 25G-подключения внешней СХД | 4 линии в выбранной схеме | По 2 на каждый Cisco; конкретное распределение по контроллерам и путям согласовать с СХД |
| Занятые 25G-порты на Cisco | По 8 на каждый: 6 хостовых + 2 СХД | Порты резервного копирования и расширения добавляются отдельно |
| Peer-link, если выбран vPC | Например, 2 × 100G между Cisco | Это отдельные линии и порты; keepalive проектируется отдельно |
| Uplink к верхнему уровню | По расчёту конкретной сети | Полоса после отказа, физические маршруты и доступ к удалённым системам |
| Кластерные интерфейсы 1G, если предусмотрено отдельное подключение | 6 портов: по 2 на хост | Два независимых пути, задержка и правила кластерной платформы |
| Управление BMC и Cisco | Минимум 5 портов для 3 BMC и 2 Cisco | Не включает управление СХД, PDU, ИБП, uplink и прочие устройства |
| Резервное копирование | Отдельно от рабочих данных | Сервер/репозиторий, сетевые порты, лицензии, изолированная или неизменяемая копия |
Если все 16 линий 25G в этом примере выполнены на оптике, потребуется 32 модуля — по два на линию — и соответствующие оптические соединения. Если все эти линии поддерживают выбранные DAC, нужно 16 кабельных сборок; отдельные парные модули для них не добавляют. Peer-link и uplink в эти количества не включены.
Кабельная ведомость должна содержать обе конечные точки каждого соединения: сервер/NIC/порт → коммутатор/порт, а также роль, VLAN, скорость, MTU и тип кабеля. Вместе со спецификацией сохраните версии программного обеспечения и план замены компонентов: иначе одинаковый артикул в заказе не гарантирует одинаковую фактическую сборку через год.
Что меняется при выборе VMware, Hyper-V, Proxmox или другой платформы?
Базовые задачи похожи, но способы их решения различаются. Меняются поддерживаемые аппаратные конфигурации, сетевые конструкции, правила HA, лицензирование и условия поддержки. Для российской платформы на KVM тоже требуется собственная проверка совместимости: наличие Linux-драйвера у NIC не подтверждает поддержку всей сборки разработчиком гипервизора.
- VMware: проверить поддержку точной системы и компонентов, доступность нужных функций в выбранном продукте и лицензиях, CPU-базис миграции, настройки vSwitch/vDS. Для vSAN отдельно проверяют профиль хранения.
- Hyper-V: согласовать версии Windows Server и ВМ, Failover Clustering, модель хранения, сетевое объединение и при необходимости RDMA. Схему SET не подменяют произвольным LACP-профилем.
- Proxmox VE: согласовать версию, драйверы и firmware, Corosync, кворум, bridge/bond и тип хранения. При Ceph добавить его CPU/RAM и нагрузку восстановления к вычислительному расчёту.
- Другие платформы: проверить матрицу совместимости, процедуры миграции и восстановления, экспорт резервных копий и границы технической поддержки.
Не закладывайте стоимость лицензий по старым правилам или только по числу серверов. В расчёт могут входить ядра, сокеты, набор функций, подписка и поддержка. Зафиксируйте коммерческую модель и состав функций в предложении на конкретную дату, а техническое решение проверьте без предположения, что все возможности доступны в базовой редакции.
Как предусмотреть питание, охлаждение и независимое управление?
Сервер с двумя блоками питания подключают к двум предусмотренным проектом цепям A/B. Если обе розетки ведут к одному PDU или общему автомату, часть рисков остаётся общей. Каждый оставшийся путь должен выдерживать нагрузку после потери второго: штатное распределение потребления между A и B нельзя использовать как предел для расчёта каждой цепи.
Допустим, измеренная нагрузка серверов, СХД и сети вместе составляет 3,6 кВт. При выбранном запасе 25% проектный ориентир равен 4,5 кВт. Если система должна продолжать работу от одной линии, именно оставшаяся линия должна обеспечивать согласованную нагрузку с учётом пусковых режимов, параметров ИБП и электрораспределения. Мощности блоков питания на шильдиках не равны постоянному фактическому потреблению.
Почти вся потребляемая ИТ-оборудованием электрическая мощность превращается в тепло. Для порядка величины 3,6 кВт соответствуют примерно 12,3 тыс. BTU/ч тепловой нагрузки. Это не готовый расчёт кондиционирования: нужны ещё температурный режим, схема движения воздуха, особенности помещения и резервирование охлаждения. У Cisco согласуют направление воздушного потока с размещением в стойке.
BMC/IPMI позволяет диагностировать выключенный или недоступный гипервизор, поэтому административный контур не стоит делать полностью зависимым от того же виртуального маршрутизатора, который предстоит восстанавливать. Предусмотрите аварийный доступ, управление питанием, журнал событий и безопасное хранение учётных данных. Один BMC-порт сам по себе не имеет двух независимых физических подключений: потеря управления и остановка ВМ — разные события.
Почему HA, репликация и резервное копирование нужны одновременно?
HA перезапускает или перераспределяет защищаемые нагрузки при определённых отказах. Репликация поддерживает дополнительные копии актуальных данных. Резервная копия позволяет вернуться к сохранённому состоянию после удаления, повреждения или нежелательных изменений. Синхронно размноженная ошибка остаётся ошибкой на нескольких носителях.
Копию стоит защищать отдельными правами и способом хранения, который выдерживает предусмотренный сценарий компрометации. Для критичных систем проверяют изолированную либо неизменяемую копию, независимость учётных данных и возможность восстановления, когда исходный кластер недоступен. Конкретная схема зависит от платформы копирования и требований к данным.
Восстановление измеряют до уровня приложения. Запустить виртуальную машину недостаточно: должны открываться база, авторизация и прикладные операции. Если DNS, каталог пользователей, менеджер виртуализации и репозиторий копий зависят друг от друга, план восстановления должен описывать порядок их запуска и аварийные способы доступа.
Отдельно рассчитайте окно полного восстановления. Возвращение 10 ТБ данных по полезному каналу 1 ГБ/с занимает минимум около 2,78 часа только на передачу. Проверка, развёртывание и запуск сервисов увеличат срок. Наличие быстрых резервных копий не подтверждает такой же скорости восстановления.
Как проверить кластер до ввода в эксплуатацию?
Испытания проводят на согласованной тестовой нагрузке или в предусмотренное окно с резервными копиями и планом возврата. Сначала фиксируют штатные CPU, RAM, IOPS, задержку приложений и загрузку интерфейсов. Затем по одному воспроизводят предусмотренные отказы и проверяют переход к оставшемуся пути. Важна и обратная операция — возврат оборудования, повторная синхронизация и стабилизация системы.
| Сценарий | Что измерять | Пример критерия для ТЗ |
|---|---|---|
| Отказ одного сетевого пути | Потери, время переключения, задержку приложения и оставшуюся полосу | Нет незапланированного перезапуска ВМ; приложение остаётся доступным в согласованных пределах |
| Потеря одного Cisco | Доступ к ВМ, хранению, управлению и внешним сервисам | Защищаемые потоки проходят по предусмотренному резервному маршруту |
| Отказ вычислительного узла | Кворум, HA, время готовности приложения, загрузку оставшихся хостов | Пройден согласованный RTO; CPU/RAM и задержки укладываются в проект |
| Миграция одновременно с копированием | Длительность миграции, p95/p99 приложения, очередь и потери на портах | Нет выхода за согласованные прикладные показатели |
| Возврат диска или узла HCI | Время восстановления реплик и влияние фоновой синхронизации | Согласованное время восстановления достигнуто без нарушения требований к приложениям |
| Потеря питания A | Состояние серверов, Cisco, СХД и нагрузку цепи B | Оставшийся контур выдерживает предусмотренную нагрузку |
| Восстановление резервной копии | Фактический RPO, RTO и целостность приложения | Сервис восстановлен в независимом тестовом контуре и прошёл прикладную проверку |
Сетевой тест запускают с подходящим числом параллельных потоков и в обоих направлениях. Отдельно проверяют один поток, чтобы не скрыть его ограничение агрегированным результатом. Измеряют ошибки и FEC-счётчики, состояние очередей, повторные передачи и маршрут к хранилищу. Чистые ping и статус линка UP не подтверждают требуемую производительность.
В отчёте сохраните версию конфигурации, состав оборудования, параметры генератора нагрузки, время испытания и полученные значения. Формулировка «тест пройден» без методики не позволяет повторить проверку после обновления драйверов или добавления четвёртого сервера.
Как перенести действующие ВМ без лишнего риска?
Разделите перенос на несколько проверяемых этапов. Сначала подготовьте адресацию, DNS/NTP, административный доступ и резервные копии. Затем подключите новый кластер и проверьте его изолированно. После этого перенесите несколько некритичных ВМ с разными профилями: обычный сервис, интенсивный дисковый обмен и приложение с внешними зависимостями.
Пилот должен проверить совместимость CPU, дисковых контроллеров и виртуальных сетевых устройств, маршрутизацию, правила межсетевого экрана и скорость приложения. При смене гипервизора дополнительно проверяют поддерживаемый способ конвертации дисков, драйверы гостевой ОС и возможность возврата. Сохранённый исходный файл ВМ не всегда означает, что обратный запуск безопасен после появления новых данных.
Для каждой группы миграции назначьте окно, ответственного, критерий остановки и способ отката. Если переносится база с непрерывной записью, нужна согласованная процедура переключения данных: запуск старой и новой копии одновременно может привести к расхождению состояния. После переноса сравните резервное копирование, мониторинг, лицензии приложения и работу интеграций.
Завершением миграции считайте подтверждённую работу сервиса и его защиты. Старый кластер выводят из эксплуатации после проверки восстановления и согласованного периода наблюдения, а не сразу после первого успешного входа в ВМ.
Что сравнивать в коммерческих предложениях и стоимости владения?
Запрашивайте одинаковый объём работ и одинаковые сценарии отказа. Дешевле может оказаться предложение без оптики, второго адаптера, системных дисков, нужной лицензии или тестов восстановления. Сравнение базовых цен серверов в таком случае ничего не говорит о стоимости работоспособного кластера.
В общую стоимость включают серверы и накопители, сеть, СХД, NIC, модули и кабели, лицензии гипервизора и копирования, поддержку, запасные компоненты, монтаж и миграцию. Добавляют электроэнергию, охлаждение и работу специалистов. Для простого ориентира постоянная ИТ-нагрузка 3,6 кВт за 8760 часов даёт 31 536 кВт·ч в год без охлаждения и потерь питания. Стоимость зависит от вашего тарифа и реального профиля потребления.
При выборе между тремя крупными и четырьмя меньшими узлами сравните не только суммарные ядра. Влияют лицензируемые ресурсы, доля мощности, теряемая при отказе, число портов, домены хранения и удобство обслуживания. Покупка максимального числа ядер может увеличить лицензионные расходы без пользы для приложения, которому важнее производительность одного ядра.
Начать подбор серверной части можно на сайте производителя Supermicro. В запросе передайте требования к совместимости и приёмке; сетевой состав Cisco согласуйте с тем же ТЗ. Условия поддержки, комплект поставки и ответственность за совместную проверку зафиксируйте в предложении отдельно.
Частые вопросы о Supermicro, Cisco и виртуализации
Можно ли подключить серверы Supermicro к Cisco без UCS и Fabric Interconnect?
Да. Стандартные Ethernet-подключения серверов Supermicro могут работать с подходящими коммутаторами Cisco. UCS и Fabric Interconnect не являются общим обязательным условием такого подключения. Проверяют конкретные NIC, модули, кабели, функции сети и поддержку гипервизора.
Обязательно ли покупать одинаковые серверы?
Одинаковые узлы проще рассчитывать, обслуживать и проверять. Разные конфигурации возможны, если их допускает выбранная платформа, но резерв считают по потере самого крупного узла, а миграцию и размещение крупных ВМ проверяют отдельно. Общая сумма RAM не устраняет ограничения отдельного хоста.
Можно ли построить кластер на двух серверах и Ceph?
Двухузловой вычислительный кластер с внешним голосом и обычный трёхузловой HCI с Ceph — разные решения. QDevice не добавляет хранилищу ещё один физический домен данных. Для типового Proxmox + Ceph проектируют как минимум три подходящих узла; двухсерверную альтернативу выбирают с другой проверенной архитектурой хранения и её ограничениями.
Нужны ли 25GbE, если сейчас сеть загружена только на 2 Гбит/с?
Сначала выясните, где и как измерены 2 Гбит/с. Это может быть средняя загрузка uplink, которая не показывает локальную запись на СХД и миграции. Если полная нагрузка, рост и аварийный сценарий укладываются в 10GbE, переход на 25GbE не обязателен. Если нет — обоснуйте скорость расчётом и тестом.
Нужен ли vPC для iSCSI?
Не автоматически. iSCSI может использовать отдельные сетевые пути и multipathing без агрегирования их в один port-channel. Схема зависит от СХД, гипервизора и его iSCSI-стека. Нельзя переносить LACP-конфигурацию сети ВМ на хранение без проверки.
Можно ли обойтись без jumbo frames?
Да, сама виртуализация не требует повсеместного MTU 9000. Выбранный MTU должен поддерживаться всей цепочкой и соответствовать архитектуре хранения. Увеличение пакета не устраняет перегрузку и не заменяет проверку скорости и задержек.
Почему после добавления NVMe сеть внезапно стала узким местом?
Накопители могут обрабатывать данные быстрее прежнего сетевого пути. При распределённом хранении к полезным операциям добавляются репликация и восстановление. Нужно сопоставить пропускную способность дисков, PCIe, NIC и портов, а не оценивать каждый компонент отдельно.
Гарантирует ли HA отсутствие простоя?
Нет. При аварийном отказе хоста ВМ и приложениям может понадобиться перезапуск. Непрерывность отдельного приложения требует его собственной архитектуры доступности и проверки зависимостей. RTO измеряют на сервисе, а не на факте включения ВМ.
Какие данные отправить для подбора инфраструктуры?
Чтобы получить сопоставимую спецификацию, подготовьте перечень ВМ и приложений, измерения CPU/RAM/дисков/сети, требования RTO/RPO, горизонт роста, выбранную платформу виртуализации и существующее оборудование. Добавьте схему стойки и питания, перечень сохраняемых Cisco, доступные интерфейсы СХД и ограничения по размещению данных.
В результате подбора должны появиться не только артикулы. Нужны схема соединений с ролями портов, адресный план, перечень версий и лицензий, расчёт ресурсов при отказе, кабельная ведомость, план миграции и программа приёмки. Когда все эти документы описывают один и тот же кластер, серверы Supermicro и сеть Cisco можно закупать и вводить в работу как согласованную инфраструктуру.