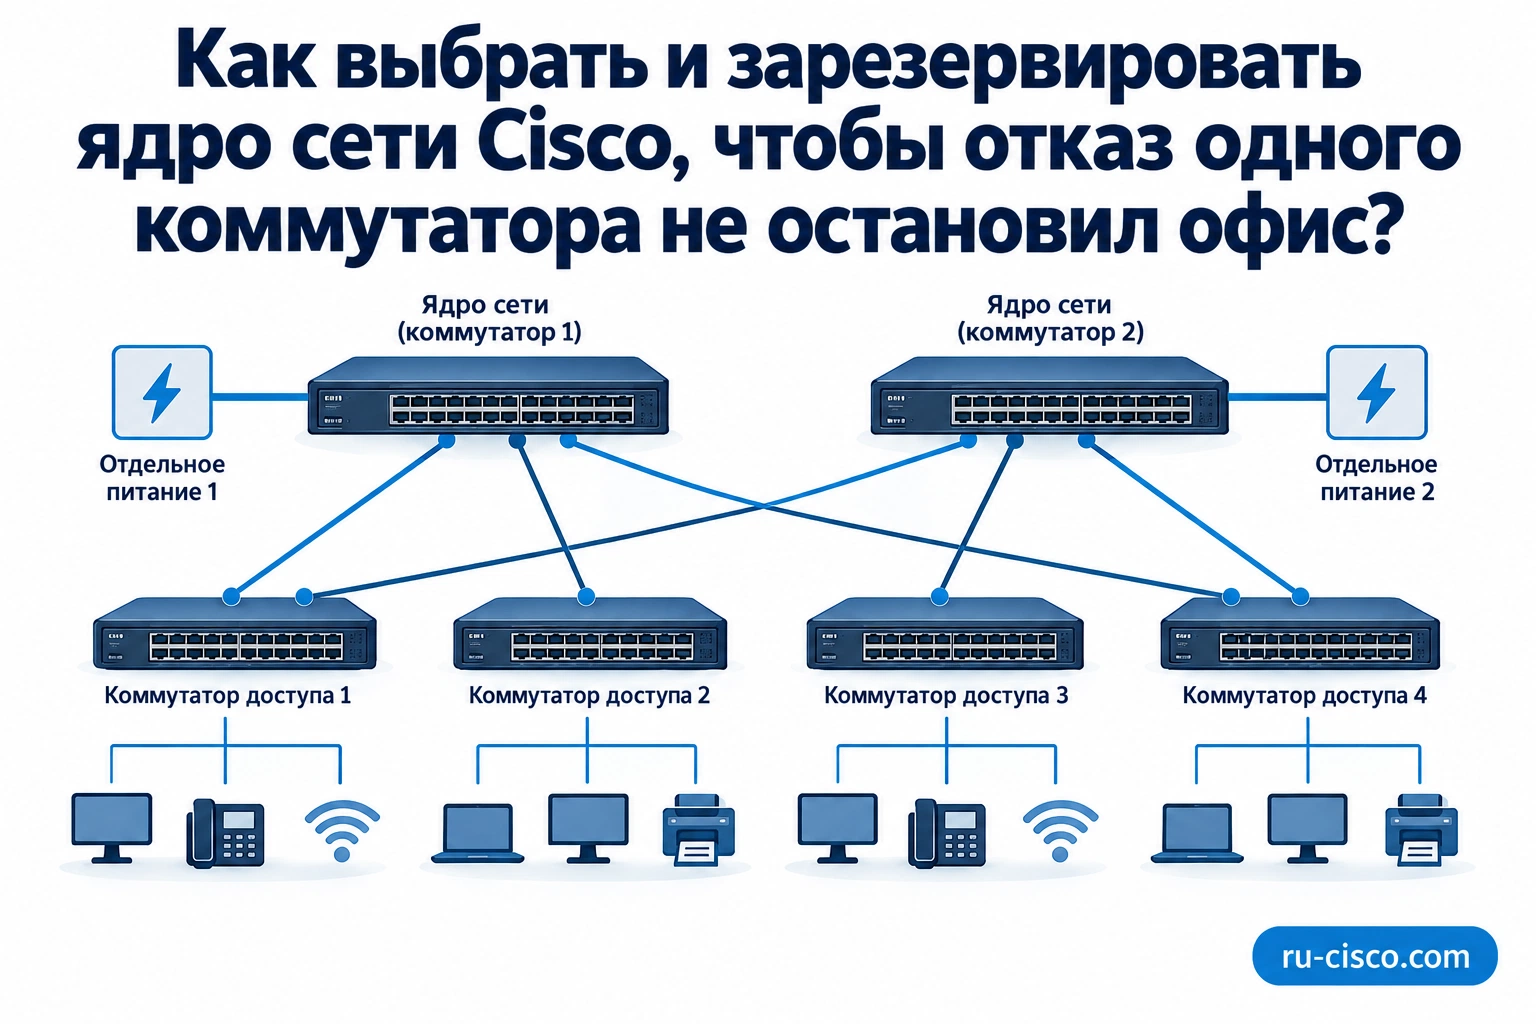
Как выбрать и зарезервировать ядро сети Cisco, чтобы отказ одного коммутатора не остановил офис?
Ядро сети Cisco выбирают по нагрузке в нормальном режиме и после отказа одного узла. Два коммутатора не дают устойчивости автоматически: нужны независимые пути, питание, подходящая маршрутизация и проверка приложений. Самый важный вопрос — какую работу сеть должна сохранить после аварии.
Для офиса и кампуса сравнивают архитектуру с независимыми L3-узлами и поддерживаемые варианты логического объединения. Эта статья отвечает за резервирование ядра. Физический стек доступа и выбор L2/L3 для отделов — другие задачи.
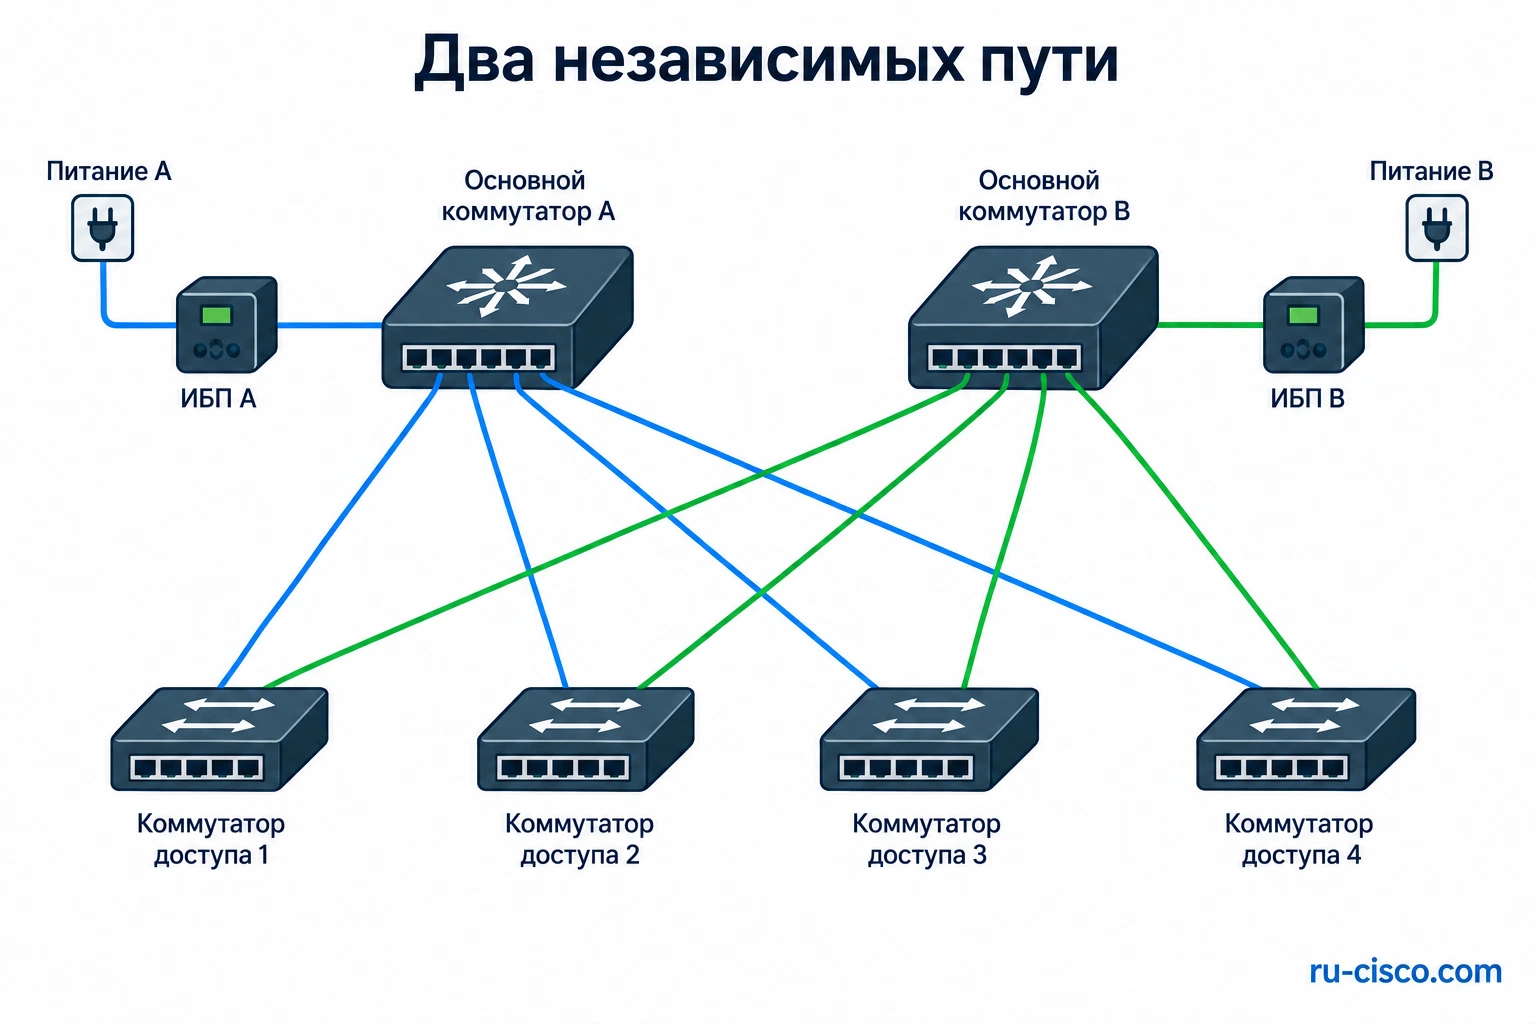
Что делает ядро сети и когда его выделять отдельно?
Ядро обеспечивает транспорт между значимыми частями сети. В небольшом офисе роли ядра и распределения могут объединяться в collapsed core. Это не ошибка само по себе: решение зависит от размера, портов, нагрузки и требований доступности.
Нужно определить границу L2/L3, места шлюзов VLAN и прохождение трафика. Если весь обмен отделов проходит через один узел, его отказ становится критичным. При этом перенос функций в ядро должен учитывать маршрутизацию, политики, масштаб таблиц и эксплуатацию.
Какие отказы должен выдерживать проект?
| Отказ | Что требуется проверить | Общая зависимость |
|---|---|---|
| Один коммутатор | Оставшийся узел и маршруты | Общая ошибка ПО или конфигурации |
| Один uplink | Доступный альтернативный путь | Общий лоток или кабельная трасса |
| Один источник | Мощность и независимость питания | Один UPS для всех вводов |
| Один управляющий канал | Поведение HA и защиты от разделения | Неправильная схема служебных связей |
| Инфраструктурный сервис | DNS, DHCP, авторизация, мониторинг | Единственный сервер сервиса |
Задайте допустимый перерыв отдельно для приложений. Для веб-доступа приемлема одна величина, для телефонии или управления — другая. Число «отказоустойчивая сеть» без времени и сценария не позволяет проверить результат.
Независимые L3-узлы или логическая пара?
Независимые L3-коммутаторы могут использовать подходящую динамическую маршрутизацию и ECMP. Они сохраняют отдельное управление и требуют согласованного адресного плана. Поведение конечных подключений, шлюзов и отказов проектируют для этой архитектуры.
Поддерживаемая логическая пара позволяет использовать соответствующие многокорпусные соединения и общую эксплуатационную модель. Для StackWise Virtual нужны подходящие модели, выпуски, служебные связи и защита от dual-active. Наличие двух корпусов одной марки не подтверждает поддержку этой функции.
Для Catalyst 9500 StackWise Virtual проверяют требования одинаковых PID и программного выпуска. Эти условия нельзя автоматически перенести на C9550. Если проект рассматривает Cisco C9550, точные функции резервирования подтверждают для выбранного исполнения и режима.
| Подход | Что удобно | Что требует внимания |
|---|---|---|
| Два независимых L3-узла | Разделение управления и часть зависимостей | Маршруты, шлюзы, адресация и эксплуатация |
| Поддерживаемая логическая пара | Общая модель и соответствующие многокорпусные подключения | Совместимость, служебные связи, dual-active, обновления |
| Один корпус с резервными компонентами | Защита отдельных внутренних элементов | Сохраняется зависимость от корпуса и места установки |
Как рассчитать uplink и нагрузку N−1?
Считайте потоки, которые действительно проходят через ядро. В примере восемь коммутаторов доступа имеют по два uplink 10G. В штатном режиме суммарная номинальная полоса подключений — 160 Гбит/с. После потери одного из двух путей у каждого остаётся по 10G, всего 80 Гбит/с. Это сумма физических подключений, а не гарантированная полезная полоса любых приложений.
Если измеренный одновременный полезный поток — 45 Гбит/с, его распределение нужно проверить по оставшимся портам и направлениям. Сумма 80 не исключает перегрузку одного конкретного выхода. Если один отдел создаёт 14 Гбит/с через оставшийся 10G uplink, общий запас ядра проблему не решает.
Агрегация также не гарантирует удвоение одного потока. Хеширование распределяет потоки по участникам. Поэтому в задании нужны максимальный поток приложения, общая одновременность и требования при отказе. Большая коммутационная способность корпуса не заменяет проверку портов.
Что важно в таблицах маршрутизации и функциях?
Проверьте число маршрутов, MAC, ARP/ND, VLAN, VRF и требуемые политики. Номинальная ёмкость может зависеть от профиля распределения ресурсов и функций. План расширения должен учитывать не только новые порты, но и новые сегменты.
Для шлюзов пользователей применяют подходящую архитектуру first-hop redundancy или другой поддерживаемый вариант. HSRP/VRRP решают задачу первого шлюза, STP — предотвращения L2-петель; это разные роли. Ни один из этих протоколов сам по себе не является полной защитой от всех отказов ядра.
Как разделить питание и кабельные пути?
Два блока питания в одном коммутаторе помогают только при подходящей схеме и достаточной мощности оставшегося источника. Если оба подключены к одному проблемному UPS, остаётся общий риск. Для двух узлов оцените стойки, цепи, распределение питания и допустимые зависимости объекта.
Резервные оптические линии по возможности разводят по независимым трассам. Два волокна в одном кабеле защищают от отдельных оптических отказов, но не от перерезания кабеля. Проверьте также совместимость оптики и скорость резервного пути.
Что включить в комплект ядра Cisco?
Нужны устройства или шасси, соответствующие внутренние компоненты, питание, вентиляторы, крепления, оптика, служебные соединения, программные права и поддержка. Состав зависит от платформы. Каталог коммутаторов Cisco помогает собрать кандидатов, но не заменяет архитектурную спецификацию.
Для логической пары в комплект явно включают необходимые связи и ограничения. Для независимых L3-узлов — адресный план, маршрутизацию и функциональные лицензии. В обоих случаях нужен план обновления и возврата: резервирование при аппаратном отказе не гарантирует безошибочное обновление.
Как проверить ядро до сдачи сети?
- Снимите исходные показатели трафика, задержки и ошибок.
- Запустите согласованные рабочие приложения.
- Отключите uplink и измерьте переход на резерв.
- Испытайте отказ одного узла и одного ввода питания.
- Для логической пары проверьте предусмотренные сценарии служебных связей.
- Верните элементы и проверьте устойчивость маршрутов и приложений.
Работы на действующей сети проводят в согласованном окне. Приёмочный протокол содержит модель, выпуск, нагрузку, сценарий и время восстановления. Синтетический тест без пользователей полезен, но не подтверждает поведение всей бизнес-системы.
Как различать резерв устройства и резерв пути?
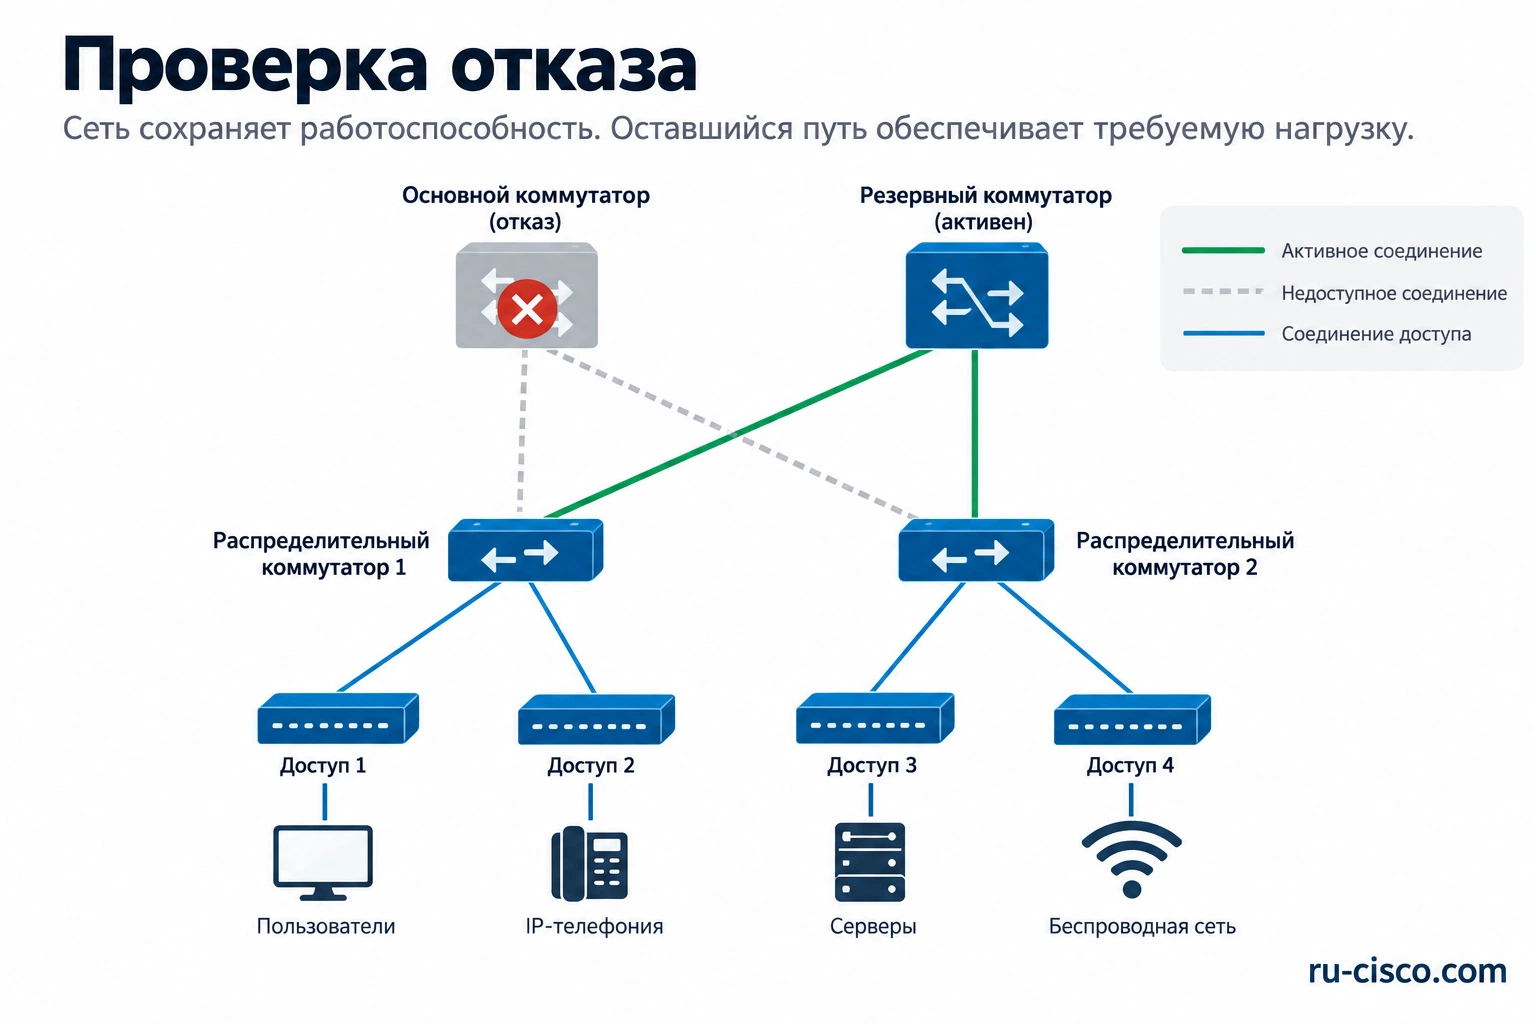
Резервный коммутатор помогает, когда клиентский трафик действительно может попасть на него. Если коммутатор доступа имеет один uplink к отказавшему ядру, наличие второго ядра в стойке не восстанавливает этот сегмент. Поэтому схему проверяют для каждого узла доступа, а не только для двух центральных корпусов.
Отдельно рассматривают серверы, WAN и защитные шлюзы. Единственный путь из ядра к firewall остаётся общей зависимостью. При необходимости резервирования проверяют интерфейсы, режимы состояния и доступную полосу каждого следующего участка. Избыточность одного уровня не описывает всю цепочку.
Для критичных приложений нарисуйте путь от клиента до сервера и отметьте каждый элемент. Затем последовательно исключайте один элемент и проверяйте альтернативу. Это практический способ обнаружить зависимость, которая не видна в списке оборудования.
Как оценить требования к обновлению и обслуживанию?
Аппаратный отказ и плановое обновление — разные сценарии. Если два узла используют общий выпуск и общую конфигурацию, некорректное изменение может затронуть оба. Нужны проверка выпуска, сохранённые настройки и поддерживаемая последовательность работ.
Заранее определите, можно ли выводить один узел в обслуживание при полной нагрузке. Проверьте оставшуюся полосу, маршруты и питание. Если нормальная работа требует обоих узлов без запаса, обслуживание может стать отдельным режимом с ограничениями. Это следует согласовать до покупки.
| Режим | Что требуется от проекта |
|---|---|
| Нормальный | Полный рабочий профиль и мониторинг |
| Один узел недоступен | Обязательные потоки на оставшемся тракте |
| Плановое обслуживание | Поддерживаемая последовательность и измеренный перерыв |
| Возврат узла | Устойчивое восстановление маршрутов и ролей |
Для логической пары проверяют сценарии разделения и механизм защиты от dual-active. Служебные связи размещают согласно выбранной платформе. Не стоит проектировать их по общей картинке из другой серии: ограничения интерфейсов и выпусков имеют значение.
Какие данные нужны для сравнения стоимости ядра?
Сравнивайте не только корпуса, но и оптику, питание, необходимые внутренние компоненты, лицензии и поддержку. Если одна архитектура требует других модулей доступа или изменения кабельной трассы, это часть бюджета. Учитывайте также эксплуатацию и период обновления.
Полезно подготовить два одинаковых сценария: требуемый профиль сейчас и рост на выбранный срок. Для каждого посчитайте нормальный режим и N−1. Предложение с большим номинальным максимумом может быть хуже, если после отказа остаётся неподходящий порт или общая точка зависимости.
Окончательный критерий — выполнение измеримых требований приложений при согласованных отказах. Количество резервных деталей, поддерживаемых протоколов и портов помогает проектировать, но не заменяет приёмочный результат.
Как определить границы ядра и убрать незаметный единственный путь?
Нарисуйте маршрут важных приложений от рабочего места до сервера или внешнего сервиса. Отметьте коммутатор доступа, распределение, ядро, firewall, хранение и инфраструктурные службы. Два корпуса в центре схемы не помогают, если оба пути сходятся в одном следующем узле или кабеле. Карта должна показывать физические и логические зависимости, а не только резервные линии на рисунке.
Для небольшой сети collapsed core может объединять распределение и ядро. При росте отдельно оценивают число подключений, длины и обслуживание. Трёхуровневая схема не становится обязательной только из-за бренда Cisco, но объединённый узел нужно рассчитывать на все его роли. Если он одновременно маршрутизирует VLAN, применяет политики и переносит большой поток к серверам, это отражается в функциях и нагрузке.
| Часть пути | Что должно быть видно | Типичная общая зависимость |
|---|---|---|
| Доступ | Оба uplink и их участники | Один физический коммутатор клиента |
| Ядро | Роль каждого узла и маршрут | Общее ПО или конфигурация |
| Серверная сторона | Поддерживаемые подключения | Единственный NIC или ToR |
| Защищённый выход | Firewall и WAN | Один пограничный тракт |
| Сервисы | DNS, DHCP, авторизация | Один недоступный сервер |
Определите, какой отказ покрывает проект и где остаётся согласованный риск. Одноподключённый принтер может иметь другой критерий, чем сервер бизнес-системы. Если рабочие места допускают ремонт за определённое время, не нужно выдавать их за беспрерывные. Для критичных устройств резервирование проверяется до конечного приложения, а не заканчивается на втором uplink коммутатора доступа.
Как выбрать независимую L3-архитектуру или поддерживаемую логическую пару?
В независимой L3-схеме у узлов отдельные управление и маршрутное состояние. Подходящая динамическая маршрутизация и ECMP могут использовать несколько путей, но для каждого сегмента нужно определить шлюз и разрешённый обмен. Обслуживание можно планировать с разделением части зависимостей. При этом эксплуатация должна понимать два самостоятельных узла и сходимость протоколов.
В логической паре доступны соответствующие многокорпусные подключения и общая модель, если это поддерживает платформа. Но служебные связи, защита от dual-active, совместимость выпуска и ограничения обновления становятся обязательной частью. У такой пары есть общие программные и конфигурационные зависимости. Выбор должен соответствовать возможностям команды и требуемым сценариям обслуживания.
| Критерий | Независимые L3-узлы | Поддерживаемая логическая пара |
|---|---|---|
| Управление | Отдельные состояния | Соответствующая общая модель |
| Пути | Маршрутизация и нужные соседства | Многокорпусные связи и служебные каналы |
| Разделение рисков | Возможно разделить часть изменений | Учитывают общее состояние и совместимость |
| Отказ связи между узлами | Поведение маршрутного проекта | Обязательный сценарий защиты от разделения |
| Обновление | План каждого узла и сходимости | Поддержка точного способа обновления |
Не выбирайте подход только по обещанию меньшего времени переключения. Для одного приложения допустимо переподключение, для другого — короткая пауза, для третьего — потеря сессии недопустима. Испытайте нужную операцию на обеих архитектурах, если сравниваете их коммерчески. Топология, которая проще на картинке, может быть сложнее в конкретной эксплуатации.
Как рассчитать каждый uplink и оставшийся узел при N−1?
Используйте одновременные потоки по направлениям. В новом расчётном примере 12 узлов доступа в пике создают по 15 Гбит/с нужного обмена через ядро. Общая полезная нагрузка — 180 Гбит/с. Каждый имеет два 25G-пути к разным сторонам. После отказа одной стороны остаётся по 25G; для каждого локального пика 15G это выглядит достаточным номинально, но нужны накладные расходы, распределение и проверка приложения.
При условном запасе 30% на один путь получается 15 × 1,3 = 19,5 Гбит/с. Для оставшегося узла суммарный ориентир — 180 × 1,3 = 234 Гбит/с. Это не означает, что любой выход этого узла пропустит 234G. Если все данные уходят к одному серверному участку с оставшимися 100G, ограничение находится там. Расчёт ядра должен содержать и входные, и выходные пути.
| Параметр примера | Расчёт | Проверка N−1 |
|---|---|---|
| Пик одного узла доступа | 15 Гбит/с | Оставшийся uplink 25G |
| Пик с условным запасом | 15 × 1,3 = 19,5 Гбит/с | Полезная работа на оставшемся пути |
| Одновременный общий поток | 12 × 15 = 180 Гбит/с | Ресурс оставшегося ядра |
| Общий ориентир с запасом | 180 × 1,3 = 234 Гбит/с | Выходы к нужным получателям |
По каждому важному потоку запишите максимум и путь. ECMP и LACP обычно распределяют подходящие потоки по доступным участникам, но не гарантируют суммирование всех линий для одной передачи. Сумма свободной полосы может скрывать перегруженный отдельный выход. Нагрузочную приёмку проводят с реальным распределением приложений, а не только с равномерным синтетическим генератором.
Как посчитать порты ядра с учётом серверов, firewall и служебных связей?
Отдельно считайте типы и скорости. Условный узел подключает 12 access-коммутаторов, два firewall-пути, диагностическую систему и необходимую служебную связь. Дополнительно используются высокоскоростные серверные соединения и, если выбранная архитектура требует, межузловые data links. Management-порт при этом имеет свою роль. Нельзя сложить все гнёзда и считать их взаимозаменяемыми.
| Роль на одном узле примера | Количество | Типовой смысл |
|---|---|---|
| Доступ | 12 | Подходящие 25G-порты |
| Firewall | 2 | Согласованные интерфейсы и схема |
| Диагностика | 1 | Предусмотренный физический ресурс |
| Служебная связь по проекту | 1 | Отдельная роль, например DAD при применимости |
| Серверные быстрые пути | 2 | Отдельные высокоскоростные интерфейсы |
| Межузловые data links при необходимости | 2 | Поддерживаемая логическая архитектура |
В этом примере нужны 16 портов первой группы и четыре быстрых интерфейса, если точная схема и платформа допускают такое распределение. Для модели с 24 подходящими портами первой группы остаются восемь, а быстрые уже заняты. Поэтому большое число свободных downlink не компенсирует нехватку высокоскоростных соединений. Рост серверной части может потребовать другой платформы или другой топологии.
C9550-24L4CD имеет 24 downlink 50/25/10/1G и вариант фиксированных uplink: четыре 100/40G либо два 400G. Нельзя считать его устройством с четырьмя одновременно доступными 400G только по цифре в названии семейства. Режимы портов, оптику и программную поддержку целевой архитектуры проверяют для точного исполнения.
Шлюз VLAN, STP и динамическая маршрутизация: какие отказы они покрывают?
First-hop redundancy решает задачу доступного первого шлюза для соответствующего сегмента. STP предотвращает L2-петлю в своей области. Динамическая маршрутизация меняет пути по определённым условиям, а ECMP может использовать несколько допустимых маршрутов. Эти механизмы нельзя назвать одним универсальным резервированием. Для каждого нужно показать роль, наблюдаемое событие и то, как восстанавливается полный путь.
Если шлюз остаётся доступным, но его uplink выше потерян, клиент может продолжать отправлять данные в тупик, если проект не учитывает такую зависимость. Если L2-сегмент разделился, маршрутная таблица другого узла не исправит любой клиентский путь. Приёмка должна включать эти разные причины, а не только отключение одного корпуса. План границы L2/L3 помогает ограничить область общей ошибки.
| Механизм | Основная задача | Что проверить дополнительно |
|---|---|---|
| HSRP/VRRP при применимости | Первый шлюз сегмента | Доступный дальнейший маршрут и tracking |
| STP | Предотвращение L2-петли | Путь и время сходимости нужного сегмента |
| Динамическая маршрутизация | Обмен и выбор маршрутов | Обнаружение реального отказа и приложение |
| ECMP | Несколько подходящих путей | Распределение и оставшийся ресурс |
| Логическая пара | Соответствующая общая архитектура | Служебные связи и разделение |
Не выбирайте минимальный таймер для всех протоколов без анализа. Более быстрый контроль способен увеличить чувствительность к кратким нарушениям и нагрузку. Параметры должны соответствовать платформе, сети и приложению. Проверяйте не только полное выключение, но и потерю пути при работающем соседнем устройстве. Это показывает, действительно ли выбранный контроль связан с доступностью нужного сервиса.
Зачем логической паре независимая защита от dual-active?
При потере межузлового обмена нужно отличить отказ соседнего узла от разрыва служебной связи. Если две стороны ошибочно считают себя активными, возможен конфликт логического состояния. Поддерживаемый механизм DAD помогает обрабатывать такой сценарий в соответствующей архитектуре. Его путь нельзя без проверки делать зависимым от того же единственного элемента, отказ которого он должен различать.
В спецификации отдельно укажите data links логической пары, DAD и управление. Они имеют разные функции и требования. Путь DAD не заменяет пользовательскую полосу, а рабочий uplink не доказывает исправность защиты от разделения. При выборе точных интерфейсов и схемы учитывайте поддержку конкретной модели и выпуска. Обычный дополнительный кабель без настроенного механизма не является готовой защитой.
Аппаратная поддержка и доступность функции в целевом выпуске — разные условия. Для C9550 нельзя автоматически переносить полный набор и поведение SSO/ISSU из другой платформы или считать все аппаратные возможности одновременно реализованными. Обязательный сценарий должен быть подтверждён для выбранного выпуска и испытан. Если он не выполняется, выбирают другую целевую комбинацию, а не обещают будущую возможность как текущую.
Испытания служебных связей требуют безопасного согласованного плана. Проверяют каждую предусмотренную причину, фактическое состояние обеих сторон и приложение. После возврата смотрят восстановление нормальных ролей. Не проводите случайные разрывы в рабочем ядре без подготовленного восстановления: задача теста — подтвердить проект, а не создавать непредусмотренный отказ всей сети.
Как проверить ресурсы таблиц и рост новых сегментов?
Количество портов описывает физические подключения, но ядро хранит маршруты, MAC, ARP/ND, ACL и другие состояния. IPv4 и IPv6 могут использовать общие аппаратные ресурсы с разными расходами. Добавление VRF, политик, телеметрии и сегментов меняет профиль распределения. Сумма независимых максимумов из разных таблиц не является автоматически допустимой одновременной конфигурацией.
Запишите фактический масштаб и целевой рост: VLAN, VRF, маршруты каждого стека, соседства, MAC, конечные адреса и правила. Для выбранной платформы проверьте подходящий аппаратный профиль и ограничения выпуска. Если смена профиля требует перезапуска, это часть плана. Не обнаруживайте необходимость изменения распределения ресурсов после включения большого нового сегмента.
| Ресурс | Что считать | Режим проверки |
|---|---|---|
| Маршруты | IPv4/IPv6 и VRF | Сейчас, рост и маршрутный отказ |
| MAC | Клиентов, серверы и нужную L2-область | Обычный и восстановительный профиль |
| ARP/ND | Адреса и переходные события | Массовые включения и изменения |
| ACL/политики | Правила и аппаратное размещение | Все нужные функции вместе |
| Телеметрия | Выбранные данные и интенсивность | Нагрузка и события аварии |
Для выбора важно не только наличие нужного протокола в лицензии, но и его масштаб. Спецификация должна показывать применимые права и ресурсы одновременно. Не делайте коммутатор ядром большой сети только по высокой терабитной ёмкости. Если таблицы или выбранный набор функций не соответствует росту, запас скорости не решает ограничение.
Как разделить питание, стойки и оптические трассы?
Для каждого узла покажите вводы, БП, PDU и ИБП. Если оба источника приходят из одного элемента, его отказ остаётся общей зависимостью. Распределение по двум стойкам также не доказывает независимость, если питание общее. Уточните границы проекта электроснабжения и необходимые последствия потери одного элемента. Оставшийся источник должен обеспечивать допустимую нагрузку, а не половину общей мощности.
Разведите предусмотренные оптические пути и сохраните их фактические трассы. Два волокна в одном кабеле не защищают от перерезания этого кабеля. Две разные трассы могут сходиться в общем незащищённом вводе. Ведомость должна включать коннекторы, патч-панели и допустимый доступ при обслуживании. Независимость оценивают на полном пути, а не по цветам патч-кордов.
Для оптики проверяют совместимые модули, скорости и линию. Ошибки слабого сигнала или неподходящего модуля могут нарушать путь без полного перехода Down. Сохраните параметры нормального режима, чтобы заметить деградацию. Для выбора пары и трассы используйте руководство по SFP/SFP+ Cisco; в проекте ядра важнее наличие двух реально проверенных путей.
Как обновлять ядро и не принимать поддержку ISSU за гарантию нулевого перерыва?
Возможности ISSU, SSO и других механизмов действуют для определённых платформ, выпусков и условий. Название функции не подтверждает любой переход между образами и любой набор сервисов. В плане нужны исходная версия, целевая, допустимый путь, ограничения и критерии приложения. Если способ обновления не поддержан, выбирают другой порядок и согласовывают перерыв.
Сохраняйте конфигурацию, образы, лицензии и ресурсы. Проверьте управление в ходе работ и порядок возврата, не рассчитывая только на сохранившуюся SSH-сессию. Для независимых узлов испытайте перенос рабочего профиля на оставшийся до начала обновления. Для логической пары — предусмотренную последовательность и состояние служебных связей. Резервный режим должен выдерживать обслуживание так же, как аппаратный отказ.
| Этап обновления | Контроль | Условие перехода дальше |
|---|---|---|
| Подготовка | Выпуски, поддержка пути, backup | Нет неразрешённой совместимости |
| Аварийная ёмкость | Нагрузка оставшегося пути | Приложения выполняют требование |
| Изменение | Роли, маршруты, интерфейсы | Предусмотренное состояние |
| Проверка | Рабочие и запрещённые обращения | Политика и сервисы сохранены |
| Возврат | Исходная доступная процедура | Понятное время восстановления |
Не совмещайте обновление ядра с неподготовленной заменой всей маршрутизации и политики. Изменения разделяют, если это допускает проект, чтобы результат можно было локализовать. После завершения обновите эксплуатационную схему и сохраните контрольный снимок состояния. Без него следующий инцидент приходится сравнивать с уже неактуальным ядром.
Какой приёмочный тест подтверждает резервирование до приложения?
Составьте матрицу отказов и назначьте обязательные сервисы. Для каждой причины измеряйте время обнаружения, изменение сетевого состояния и восстановление операции. Это могут быть разные интервалы. Проверяйте новый вход, существующую сессию и фоновую передачу, если они важны. Один непрерывный ping полезен как наблюдение, но не описывает все последствия для телефона, базы данных или файлового сервиса.
| Сценарий | Сетевой контроль | Контроль приложения |
|---|---|---|
| Один access-uplink | Оставшийся путь и полоса | Работа нужной группы пользователей |
| Один core-узел | Маршруты, шлюзы, ресурсы N−1 | Согласованный аварийный профиль |
| Служебная связь пары | Защита от разделения и роли | Нет непредусмотренного доступа или перерыва |
| Один ввод питания | Источники и реальная нагрузка | Сервисы продолжаются по плану |
| Деградация пути | Потери, очереди, ошибки | Приемлемые операции под нагрузкой |
| Возврат элемента | Сходимость и роли | Нет повторного недопустимого нарушения |
Приёмка повторяется после существенного роста, изменения топологии или новых критичных функций. Сохраняйте модель, выпуск, профиль нагрузки, время и наблюдения обеих сторон. Если отказ не был испытан, не отмечайте его как подтверждённый только по наличию поддержки функции. Для коммерческого выбора это конкретное ограничение, которое можно включить в план работ.
Что должно быть в спецификации двухузлового ядра Cisco?
Когда ядро кампуса и серверный ToR нужно считать отдельно?
Ядро кампуса агрегирует соответствующие части офисной сети, а серверный ToR обслуживает подключения и профиль серверной стойки. Они могут иметь разные требования к портам, буферам, режимам управления и архитектуре. Высокая скорость одного семейства не делает его универсальным ответом на обе задачи. Если проект объединяет роли, нужно показать каждую нагрузку, необходимые функции и последствия отказа общего узла.
Для NAS и виртуализации важны обмен между серверами, доступ к хранению, микровсплески и поддерживаемая схема двух подключений. Для кампуса — пути доступа, шлюзы, сегменты и эксплуатация. В одном проекте эти требования связаны, но спецификации могут оставаться разными. Не рассчитывайте core только по офисному интернету, если через него действительно проходит большой серверный поток. И не прибавляйте внутренний обмен, который остаётся на другом локальном пути.
Отметьте east-west и north-south потоки на схеме, если эти обозначения помогают команде, и подпишите их обычными словами: между серверами или между сетью и внешними ресурсами. Затем измерьте, какие интерфейсы используются. Без такой карты суммарные мегабиты могут попадать в расчёт дважды или не учитываться вовсе. Выбор оборудования начинается с фактического пути, а не с универсального ярлыка «ядро».
Как убедиться, что резерв ядра не заканчивается на DNS или серверной сети?
После отказа одного core-узла проверьте получение адреса, разрешение имени, авторизацию и бизнес-операцию на новом клиенте. Уже открытая сессия может продолжаться, а новый сотрудник не сможет войти из-за недоступного сервиса. Этот эффект легко пропустить в тесте, где все клиенты подключены заранее. Нужны и существующие, и новые операции, а также серверы на разных путях.
| Зависимость | Проверка в режиме N−1 | Что может скрыть заранее открытая сессия |
|---|---|---|
| DHCP | Новый клиент получает нужный адрес | Продление пока не потребовалось |
| DNS | Имя разрешается с рабочего пути | Ответ остался в кэше |
| Авторизация | Новый вход выполняется | Существующий токен ещё действует |
| Серверный тракт | Операция идёт через оставшийся путь | Тестовый сервер был на удобной стороне |
Если сервис резервирован, проверьте его правильную доступность из каждого нужного сегмента. Два DNS-сервера за одним отказавшим коммутатором сохраняют общую зависимость. Аналогично две ВМ авторизации на одном недоступном хосте не подтверждают устойчивость сети. Ответственность за приложение и сеть можно разделить, но критерий результата должен быть общим и понятным.
Какие показатели наблюдать после запуска ядра?
Отдельно согласуйте сочетания отказов. N−1 одного узла не подтверждает работу при одновременной потере узла и другого критичного пути. Также во время обслуживания часть резерва уже занята плановым отключением. Если бизнес требует пережить ещё одну аварию в этот период, это дополнительный сценарий с другими ресурсами. Название «два коммутатора» не описывает его автоматически.
Укажите такие комбинации в матрице и сравните стоимость их покрытия с согласованным ограничением. Тогда второй узел, независимое питание и дополнительные линии будут относиться к конкретным требованиям, а эксплуатация будет знать, в каком состоянии сеть имеет полный резерв и когда работает с уменьшенной устойчивостью.
Сохраняйте нагрузку отдельных портов, потери очередей, физические ошибки, состояния соседств и переходы ролей. Общая средняя загрузка корпуса не показывает краткий перегруженный выход. Также полезны количество маршрутов и других состояний в применимом профиле. Механизм телеметрии выбирают из реально поддерживаемых функций выпуска, не считая любую аппаратно заявленную возможность уже включённой.
Задайте условия уведомления и ответственного за разбор. После роста офиса сравните данные с проектным N−1, а не только с прежним средним. Если новые серверные потоки занимают весь оставшийся uplink, проверьте модернизацию до аварии. Наблюдение превращает первоначальный резерв в поддерживаемый эксплуатационный результат, когда нагрузка и состав сети меняются.
Включите точные устройства, память или компоненты при применимости, питание, вентиляцию, оптику всех путей, служебные связи, лицензии и поддержку. Отдельно укажите монтаж, адресный и маршрутный план, политику, наблюдение и приёмку. Сравнение стоимости одного корпуса с ценой полной пары не показывает реальную экономику проекта.
Для подбора ядра Cisco с резервом N−1 передайте карту путей, таблицу портов, профиль приложений и сценарии обслуживания. Попросите показать ресурс каждого оставшегося интерфейса и совместимость выбранного выпуска. Такая спецификация связывает второй узел с проверяемой доступностью и ростом сети, а не только с запасным местом в стойке.
Частые вопросы о резервировании ядра
Два коммутатора всегда лучше одного шасси?
Сравнивают общие зависимости, требования и эксплуатацию. Число корпусов само по себе не определяет доступность.
Нужно ли объединять ядро в стек?
Не всегда. Независимая L3-архитектура и логическая пара решают задачу по-разному. Проверяют функции выбранной платформы.
Можно ли обещать переключение без потери пакетов?
Только при подтверждённом конкретном сценарии. Для проекта измеряют приложения и допустимый перерыв, а не делают универсальное обещание.
Достаточно ли двух uplink из доступа?
Нужны независимые пути и поддерживаемый режим подключения. При отказе оставшаяся полоса должна соответствовать нагрузке.
Почему сеть перегружена при свободной общей полосе?
Ограничение может быть на отдельном выходном порту или пути. Смотрите распределение, очереди и конкретные потоки.
Можно ли использовать C9550 по инструкции C9500?
Нельзя переносить все функции и условия по сходству названия. Проверяют точный PID и программный выпуск.
ECMP гарантирует одинаковую загрузку двух путей?
Нет. Распределение зависит от потоков и алгоритма, а отдельный поток обычно не делится произвольно между всеми линиями. Проверяйте фактическую загрузку выходов и поведение крупных передач. Суммарная свободная полоса может сочетаться с перегрузкой одного пути. Требования приложения и результаты испытания важнее идеального равного деления в расчёте.
Можно ли резервировать только ядро и оставить один firewall?
Такой проект защищает от части отказов ядра, но сохраняет зависимость от firewall для проходящих через него задач. Если бизнес требует доступности этих приложений, проверяют всю цепочку. Не все элементы обязаны иметь одинаковую схему резерва, но последствия каждого отказа должны быть согласованы.
Как проверить возвращение отказавшего узла?
После восстановления следите за маршрутами, ролями, ошибками и приложениями. Испытание не заканчивается, когда корпус снова включён. Нужен возврат к нормальной топологии без нестабильных переключений. Сохраните состояние до отказа, во время него и после восстановления, чтобы подтвердить полный цикл.
Как выбрать и купить ядро сети Cisco?
Передайте схему, портовую ведомость, профиль трафика, число сегментов, план роста и требования при отказе через форму подбора. Попросите сравнить архитектуры с полным комплектом и нагрузкой N−1. Так предложение будет отвечать требованию доступности, а не только числу портов.