Как выбрать сервер Cisco UCS для виртуализации: процессоры, память, диски, сеть и резерв мощности?
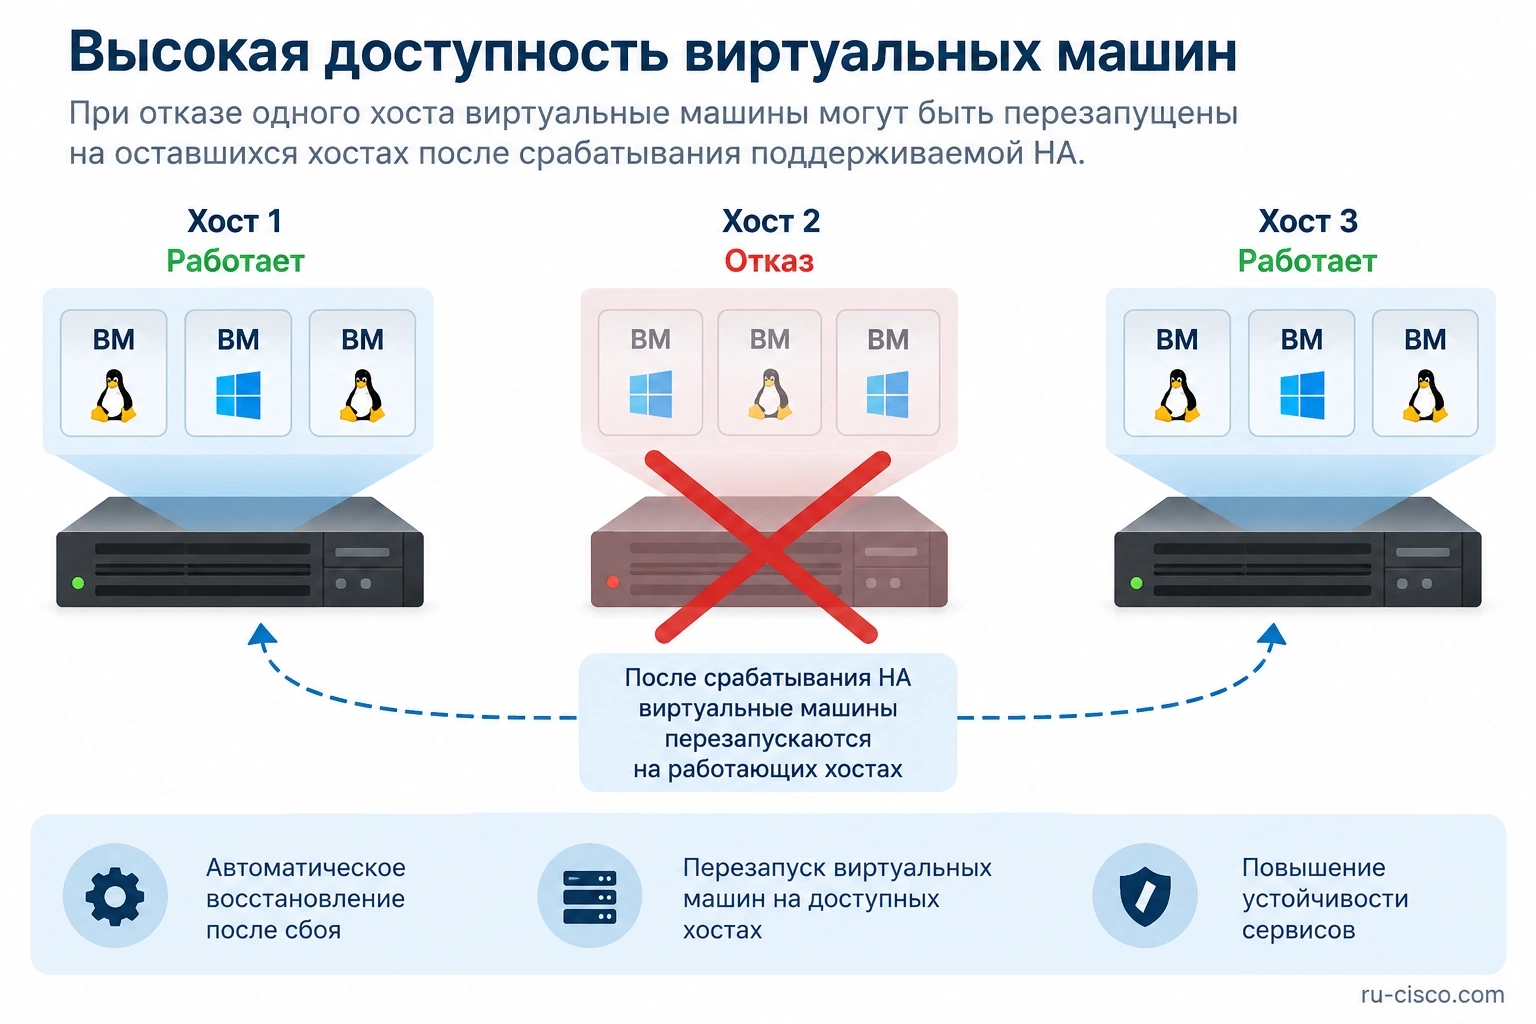
Сервер Cisco UCS для виртуализации выбирают по четырём ресурсам: CPU, RAM, хранилищу и сети. Число виртуальных машин само по себе не определяет конфигурацию. Двадцать лёгких сервисов и двадцать нагруженных баз данных предъявляют разные требования, даже если им выдано одинаковое число vCPU.
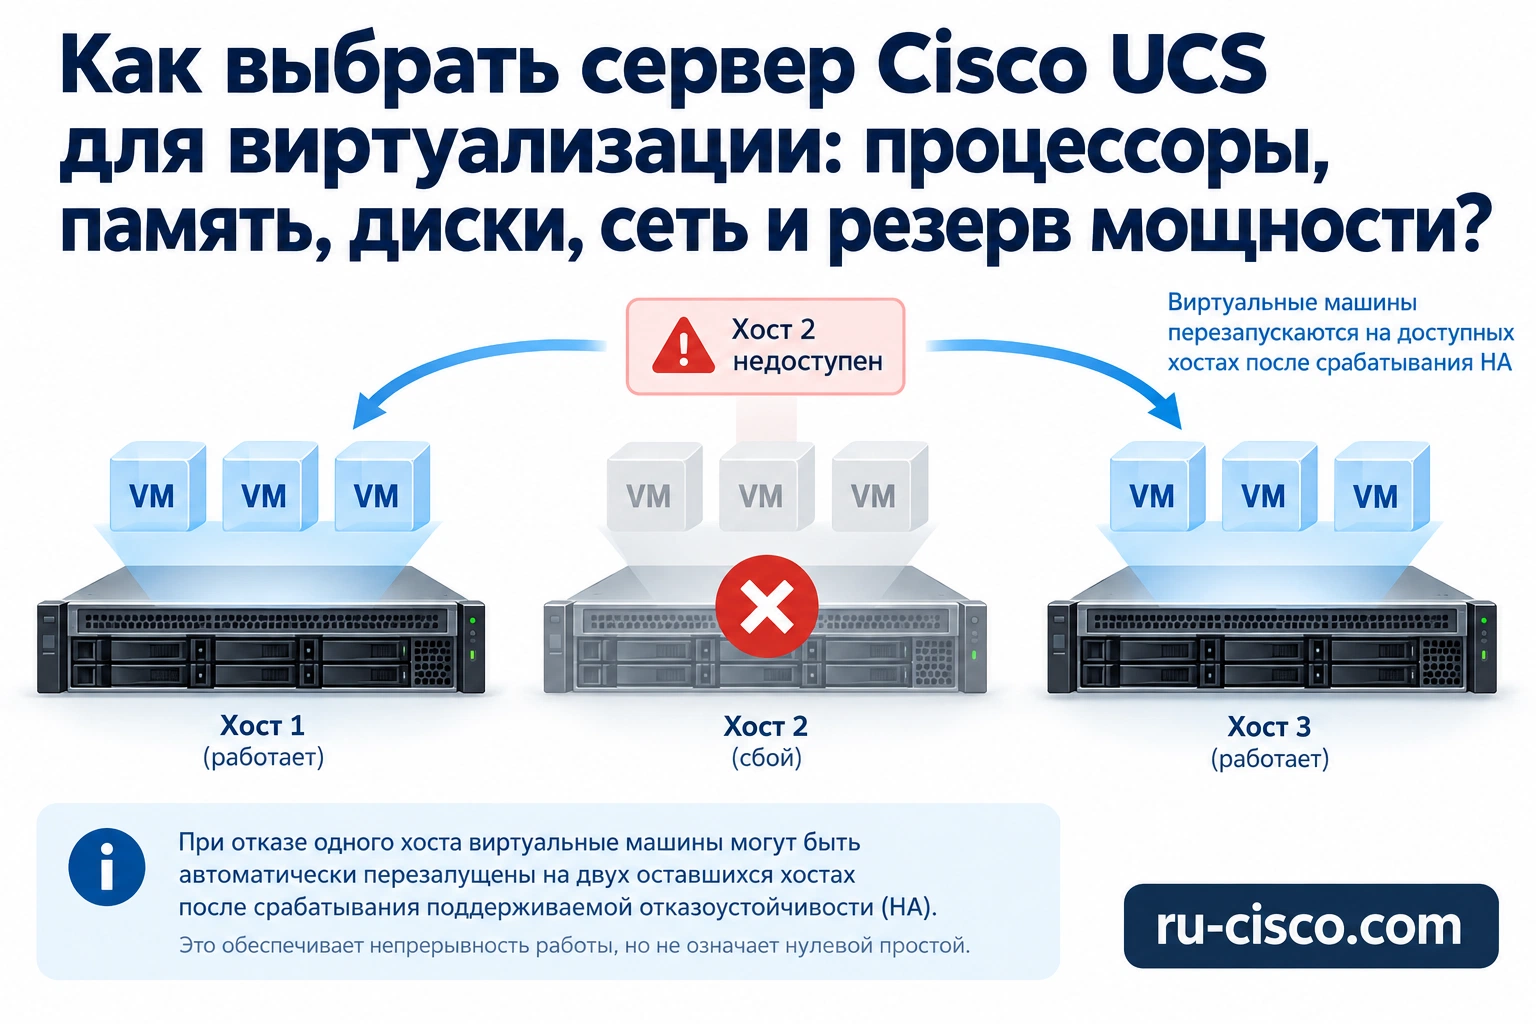
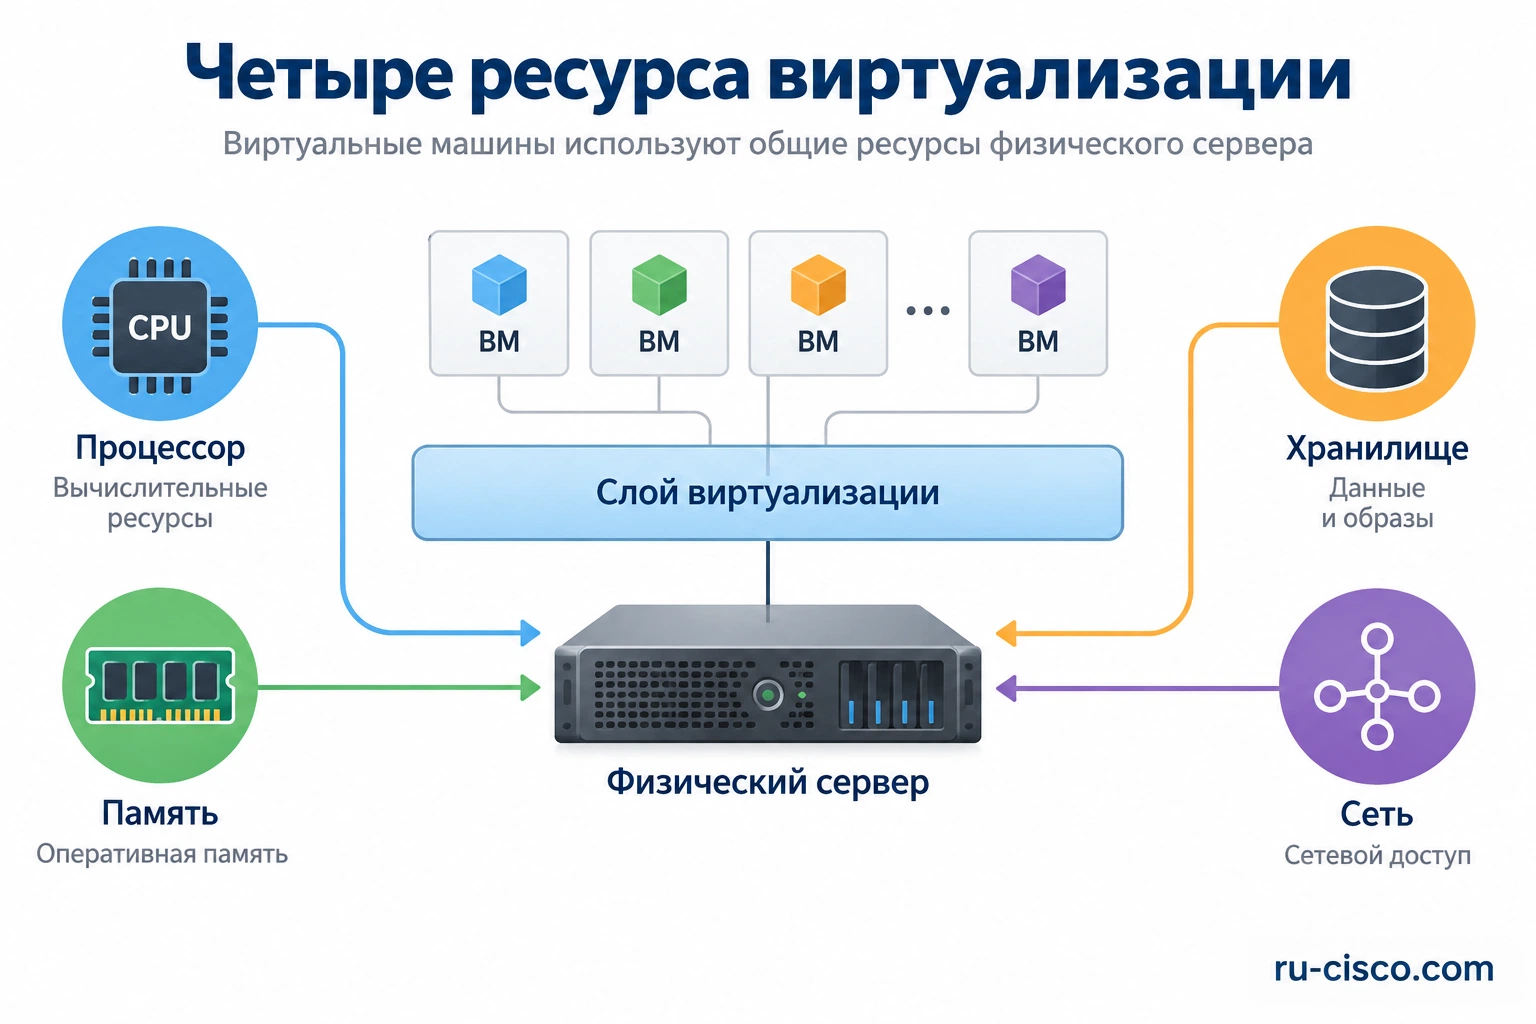
Для кластера добавляется пятое условие: работа после отказа одного хоста. Если все ресурсы заняты в нормальном режиме, перезапуск ВМ на оставшихся узлах может оказаться невозможным. Ниже — расчёты, критерии конфигурации UCS и план пилота.
Какие данные собрать по виртуальным машинам?
Ведомость содержит назначение ВМ, ОС, выделенные vCPU и RAM, фактическую нагрузку, объём данных и требования к задержке. Замеряют пиковые и длительные значения, а также план роста. Простая сумма выделенных vCPU часто завышает или искажает потребность в процессорах.
Разделите приложения на группы: базы данных, терминальные среды, инфраструктурные сервисы, обработку файлов и вычисления. Для каждой определите допустимую задержку и поведение при отказе. ВМ с небольшим средним CPU может иметь важный короткий пик, а фоновая задача — переноситься во времени.
| Ресурс | Что измерять | Чего недостаточно |
|---|---|---|
| CPU | Пики, длительная загрузка, задержка планирования | Числа выданных vCPU |
| RAM | Рабочий объём, резерв, host overhead | Свободной памяти в один спокойный час |
| Storage | IOPS, задержка, размер блока, чтение/запись | Объёма дисков в ТБ |
| Network | Полоса, потоки, migration, backup | Суммы номинальных портов |
| Отказ | Размещение на оставшихся узлах | Успешной работы при всех хостах |
Сколько процессорных ядер нужно для виртуализации?
Оценка начинается с реальной работы приложений и сравнимой производительности CPU. Фиксированное правило «четыре vCPU на одно ядро» не подходит всем задачам. Для лёгких сервисов oversubscription может быть приемлем, для постоянно загруженной базы — нет. SMT также не удваивает производительность каждого приложения.
Если существующий хост с 32 физическими ядрами длительно загружен на 60%, это не означает, что новый процессор с 20 ядрами обеспечит тот же результат. Отличаются частота, архитектура, память и профиль программы. Для значимого приложения полезен пилот или проверенный сопоставимый тест.
Большое число ядер может увеличивать стоимость лицензий приложений. Иногда меньшая конфигурация с подходящей производительностью на ядро выгоднее. Рассчитывайте аппаратную цену вместе с лицензированием гипервизора и ПО, применимым к конкретному проекту.
Как рассчитать RAM и резерв N+1?
Пусть суммарный рабочий объём памяти ВМ составляет 900 ГБ. В кластере из трёх хостов после отказа одного остаются два. Простая нижняя оценка — 900 / 2 = 450 ГБ на каждый оставшийся хост. К ней добавляют накладные расходы гипервизора, системные сервисы и согласованный запас. Конфигурация ровно 450 ГБ не является готовым выбором DIMM.
Если к 450 ГБ добавлены условные 30 ГБ overhead и 20% запаса на полученную сумму, ориентир равен (450 + 30) × 1,20 = 576 ГБ. Это пример расчёта, не рекомендация всем UCS. Реальная схема DIMM должна соответствовать каналам памяти, CPU, поддерживаемым модулям и правилам заполнения.
| Шаг примера | Расчёт | Результат |
|---|---|---|
| Рабочая RAM ВМ | Исходное допущение | 900 ГБ |
| Оставшиеся хосты | 3 − 1 | 2 |
| ВМ на один оставшийся хост | 900 / 2 | 450 ГБ |
| С накладными расходами | 450 + 30 | 480 ГБ |
| С запасом | 480 × 1,20 | 576 ГБ, затем подбор схемы DIMM |
N+1 предполагает, что нагрузки можно распределить по оставшимся ресурсам. Ограничения affinity, лицензии, локальные данные и устройства passthrough могут помешать такому распределению. Проверяйте фактический план HA, а не только общую сумму RAM.
Зачем учитывать NUMA и заполнение памяти?
У двухпроцессорного сервера память связана с соответствующими CPU и каналами. Размещение ВМ и доступ к памяти влияют на производительность. Большая ВМ, неудобно размещённая по NUMA, может вести себя иначе, чем несколько меньших. Настройку оценивают по гипервизору и приложению.
Число DIMM, ёмкость, частота и расположение должны соответствовать правилам платформы. Установка максимального объёма не гарантирует максимальную частоту. Для однопроцессорной конфигурации часть ресурсов, привязанных ко второму CPU, может быть недоступна. Состав PCIe и памяти проверяют вместе.
Как выбирать диски: ТБ, IOPS или задержка?
Нужны все показатели. Ёмкость определяет размещение данных, IOPS — число операций, задержка — время ответа, а МБ/с — объём обмена. В примере 20 тысяч операций по 4 КиБ соответствуют примерно 81,9 МБ/с полезных данных, а те же 20 тысяч по 64 КиБ — 1 310,7 МБ/с. Одинаковые IOPS не означают одинаковую полосу.
Разделяйте чтение и запись, случайный и последовательный доступ. Учитывайте устойчивую производительность, ресурс записи, RAID или другую схему защиты и работу при отказе накопителя. Rebuild способен влиять на задержку. Число установленных SSD не заменяет тест приложения.
Определите, где находятся данные: локально, на внешней СХД или в поддерживаемой распределённой архитектуре. Для HA локальный диск требует отдельного решения доступности данных. Перезапуск ВМ на другом сервере невозможен только на основании свободной RAM, если её данные остались на недоступном узле.
Какая сеть нужна UCS для виртуализации?
Разделите управление, рабочий трафик, storage, миграцию и резервное копирование. Эти задачи могут конкурировать за интерфейсы. Для двух 25G-портов нельзя автоматически обещать одному потоку 50G: режим распределения и приложение имеют значение.
Если требуется передать 1 ТБ памяти или данных за 15 минут, нижняя оценка полезной скорости составляет 8,89 Гбит/с. Реальная миграция может иметь дополнительную работу и повторную передачу изменённых данных. Проверяйте требования приложения и гипервизора, а не только этот арифметический ориентир.
Для выбора проводного узла используйте проверку NIC, uplink и резервного режима. Два серверных порта в одном коммутаторе оставляют общий риск корпуса. У каждого оставшегося пути после отказа должна быть достаточная полоса.
UCS C-Series или X-Series: как выбирать?
Cisco UCS C-Series рассматривают для стоечных конфигураций. UCS X-Series — для соответствующей модульной архитектуры. Выбор зависит от масштаба, управления, подключений и имеющейся инфраструктуры, а не только от числа ВМ.
Например, UCS C240 M7 — двухпроцессорная платформа 2RU с 32 слотами DDR5, по 16 на процессор. Возможности памяти, частоты и дисковых вариантов зависят от CPU и конфигурации. Не считайте максимумы памяти, дисков и расширений одновременно доступными в любом готовом SKU.
Модульная система требует полного инфраструктурного комплекта. При сравнении с rack-серверами учитывают шасси, подключение, управление, питание и лицензии. Цена одного вычислительного узла не описывает цену работающего решения.
Как проверить гипервизор и совместимость?
В HCL проверяют не только базовую модель UCS, но и CPU, контроллер, NIC, накопители, firmware и драйверы для выбранного гипервизора. Поддержка шасси не означает поддержку любой установленной карты. Программный выпуск и рекомендованный комплект firmware сохраняют в спецификации.
Если используются passthrough, SR-IOV или специализированные ускорители, проверьте ограничения миграции и HA. Поддержка устройства одной ВМ не подтверждает бесшовный перенос на другой хост. Эти условия влияют на план отказа.
Что проверить в пилоте?
- Рабочие приложения и их задержку в обычный и пиковый режим.
- CPU, память и признаки перегрузки планирования.
- Storage под нужной смесью операций, включая отказ и rebuild при применимости.
- Миграцию, backup и рабочую сеть одновременно.
- Потерю одного хоста и размещение обязательных ВМ.
- Восстановление и обновление firmware по согласованной процедуре.
Сохраните параметры ВМ и условия сравнения. Изменение числа vCPU, RAM и нагрузки между тестами делает выводы ненадёжными. Дополнительно проверьте время восстановления, а не только факт успешного перезапуска.
Почему важен полный комплект, а не только артикул сервера?
Одинаковая базовая платформа может иметь разные процессоры, DIMM, контроллеры, NIC и дисковые корзины. Поэтому сравнение цен двух UCS по названию C240 без конфигурации малоинформативно. В спецификации указывают каждую позицию и её влияние на задачу.
Особенно внимательно проверяют пути расширения. Дополнительные DIMM должны соответствовать правилам заполнения, новые диски — корзине и контроллеру, NIC — слотам и совместимости. Если для расширения требуется заменить уже приобретённые компоненты, это нужно учитывать в бюджете заранее.
«Разобравшись с логикой и основными принципами настройки, мы без труда собрали и запустили оборудование».
nikolay_aralovets, автор материала в корпоративном блоге MWS Cloud, о своём проекте UCS в публикации 2020 года.
Это описание конкретного опыта, а не обещание сроков вашего внедрения. Практическая польза подготовки состоит в согласованных профилях, firmware и понятной процедуре запуска. Для нового поколения UCS такой процесс проверяют отдельно.
Как подготовить план расширения кластера?
Запишите будущие ВМ, рост данных и предполагаемые новые приложения. Дополнительный хост меняет распределение нагрузки, но также требования хранения, сетей и лицензий. Нельзя считать, что добавление любого сервера автоматически увеличит все четыре ресурса одинаково.
Если в кластере смешаны поколения CPU, проверяют совместимость миграции и требуемые режимы. Разница поддерживаемых инструкций может влиять на перенос ВМ. Для совместимого режима оцените и возможное ограничение функций. Это задача гипервизора и приложения, которую аппаратная таблица UCS не решает сама.
В пилоте после расширения повторяют N+1. Дополнительный хост может улучшить ресурсный запас, но общая СХД или uplink остаются прежними. Сохраните показатели до и после, чтобы убедиться, что расширение устранило нужное ограничение, а не переместило его на другой участок.
Как составить ведомость виртуальных машин для покупки сервера?
Запишите не только выданные vCPU и RAM, но и назначение ВМ, рабочие пики, размер данных, профиль storage и критичность. Разделите гарантированные ресурсы и наблюдаемый рабочий объём. Если приложение требует reservation или запрещает oversubscription, это обязательное условие, а не рекомендация на усмотрение администратора. Для других нагрузок допустимость уплотнения подтверждают измерением.
Сохраняйте период замера и события, попавшие в него. Спокойная неделя без расчёта зарплаты или закрытия периода не описывает все пики. Нужны массовый вход, пакетная обработка, backup и восстановление после перерыва. Укажите также требования к порядку запуска: база, каталог и приложение могут зависеть друг от друга. Даже достаточно большой кластер должен восстановить сервисы в правильной последовательности.
| Поле ВМ | Что записать | Как влияет на конфигурацию |
|---|---|---|
| Роль | Сервис и владелец | Критичность и тест |
| CPU | vCPU, фактическую нагрузку, reservations | Ядра, производительность и размещение |
| RAM | Выданный и необходимый объём | Память и гарантии N+1 |
| Storage | Данные, IOPS, блоки, задержку | Диски/СХД и контроллер |
| Сеть | Потоки, migration, backup | NIC и серверный тракт |
| Ограничения | Affinity, passthrough, лицензии | Возможность переноса и HA |
Для нового проекта используйте согласованные допущения и замените их измерениями пилота. Не выдавайте список «64 ВМ» за готовый расчёт. Две ВМ одного размера могут иметь разные CPU и дисковые требования. Список помогает собрать ресурсы, а решение принимают по обязательной нагрузке и её размещению в оставшейся системе.
Расчёт 64 ВМ: сколько RAM нужно трёхузловому кластеру после отказа?
Рассмотрим учебный набор: 48 небольших сервисов по 8 ГБ, 12 приложений по 16 ГБ и четыре базы по 64 ГБ. Если этот объём требуется гарантировать, сумма составляет 384 + 192 + 256 = 832 ГБ. В кластере из трёх одинаковых хостов после отказа одного остаются два. При допустимом равномерном размещении нижняя оценка ВМ-памяти на оставшийся хост — 416 ГБ.
Допустим, для host overhead и соответствующих сервисов задано 24 ГБ на хост, затем принят запас 20% на полученную сумму. Получается (416 + 24) × 1,2 = 528 ГБ. Это расчётный ориентир, а не готовая схема DIMM. Подбирают поддерживаемый объём с правильным заполнением каналов и проверяют реальное размещение крупных ВМ. Если ограничения не позволяют делить нагрузку поровну, формула требует изменения.
| Группа | Количество | RAM на ВМ | Всего |
|---|---|---|---|
| Небольшие сервисы | 48 | 8 ГБ | 384 ГБ |
| Приложения | 12 | 16 ГБ | 192 ГБ |
| Базы | 4 | 64 ГБ | 256 ГБ |
| Итого | 64 | Разные размеры | 832 ГБ |
| На два оставшихся хоста | 832 / 2 | 416 ГБ на хост | Затем overhead |
| Ориентир с запасом | (416 + 24) × 1,2 | 528 ГБ на хост | Затем поддерживаемый комплект |
Если выбрать по 512 ГБ, это меньше заданного ориентира 528 ГБ, хотя три хоста в нормальном режиме имеют много суммарной памяти. Если выбрать больший объём, нужно подтвердить поддерживаемые DIMM, скорость и CPU. Запас по сумме не отменяет NUMA и restrictions отдельных ВМ. В испытании отключите предусмотренный хост и проверьте все обязательные нагрузки, а не только одну небольшую машину.
Почему 192 vCPU не определяют число физических ядер?
Для того же учебного набора можно задать два vCPU небольшому сервису, четыре приложению и двенадцать базе: 48 × 2 + 12 × 4 + 4 × 12 = 192 vCPU. Это распределённые виртуальные ресурсы, а не измеренная потребность в 192 физических ядрах. Если каждый хост имеет условные 48 физических ядер, после отказа остаются 96. Арифметическое отношение 192 / 96 = 2:1 не подтверждает допустимость такого уплотнения.
Часть ВМ может простаивать, другая постоянно загружать выделенные ресурсы. Производительность ядра, NUMA, частоты и требования приложения влияют на результат. SMT нельзя считать автоматическим удвоением ресурсов. Для latency-sensitive базы слишком большая ВМ может усложнить планирование. Подбирать vCPU нужно по нагрузке и требованиям, а не выдавать максимальное число всем машинам.
| Наблюдение | Что означает | Что ещё проверить |
|---|---|---|
| Низкий средний CPU | Часть времени ресурс свободен | Короткие пики и задержку планирования |
| Высокий CPU приложения | Рабочая нагрузка тяжёлая | Производительность ядра и масштабирование |
| Много выданных vCPU | Большой виртуальный размер | Реальную пользу и scheduling |
| Приемлемо на трёх хостах | Работает штатный состав | Тот же профиль на двух |
Для специальных приложений Cisco Unified Communications и другого ПО могут действовать собственные правила без допустимого произвольного CPU/RAM oversubscription. Не переносите эти требования на все ВМ и не игнорируйте их для самой такой нагрузки. Сначала проверяют application sizing, затем общий кластер. Если ВМ должна получить гарантированный ресурс, её reservation входит в расчёт отказа.
Как подобрать DIMM и CPU, чтобы объём памяти не скрывал другое ограничение?
У UCS C240 M7 32 слота DDR5, по 16 на CPU. Поддерживаемые модули и скорость зависят от поколения процессора и схемы заполнения. До 5600 MT/s относится к подходящей конфигурации с пятым поколением Xeon Scalable, а варианты с четвёртым имеют другие условия. Установка всех максимальных модулей не гарантирует одновременно максимальную частоту.
Для выбранного объёма сравните поддерживаемые схемы. Например, при применимости соответствующих модулей 16 × 48 ГБ дают 768 ГБ, а 16 × 64 ГБ — 1024 ГБ. Но ёмкость по арифметике не подтверждает поддержку первого варианта с любым CPU. Нужны правильный тип, порядок установки, симметрия и перечень допустимых компонентов. Итоговая спецификация должна содержать полный комплект DIMM, а не только «RAM 768 ГБ».
С одного CPU нельзя автоматически получить ресурсы, привязанные ко второму. Некоторые слоты памяти и PCIe требуют соответствующего процессора или riser. Для крупной ВМ важны размещение по NUMA и локальность памяти. Для сети и дисков — доступные слоты и линии. Проверяйте всю конфигурацию одновременно: CPU, DIMM, riser, NIC, контроллеры и выбранное охлаждение.
Как рассчитать полезную ёмкость дисков и почему число ТБ недостаточно?
Разделите сырую ёмкость, полезный объём после защиты, данные приложений, snapshots, резерв и место для восстановления. Thin provisioning не создаёт физические диски: обещанные ВМ объёмы должны быть обеспечены планом роста и наблюдения. Если данные хранятся на внешней СХД, считать только внутренние диски UCS неправильно. Если локально — нужно учесть весь путь доступности после отказа хоста.
Учебный проект содержит 12 ТБ данных и ожидает рост 30%: 15,6 ТБ. Дополнительно требуется 2 ТБ для предусмотренных временных данных и snapshots, итого 17,6 ТБ до других расходов. Восемь накопителей по 3,84 ТБ дают 30,72 ТБ сырых. В условном RAID10 половина остаётся полезной — 15,36 ТБ; в условном RAID6 без hot spare — 23,04 ТБ. Первый вариант уже не покрывает заданный объём, хотя сумма маркировки дисков значительно больше.
| Ёмкость примера | Расчёт | Результат |
|---|---|---|
| Данные после роста | 12 × 1,3 | 15,6 ТБ |
| Данные и временный объём | 15,6 + 2 | 17,6 ТБ |
| Сырая ёмкость | 8 × 3,84 | 30,72 ТБ |
| Условный RAID10 | 4 × 3,84 | 15,36 ТБ до других расходов |
| Условный RAID6 | (8 − 2) × 3,84 | 23,04 ТБ до других расходов |
Эта арифметика не выбирает RAID за вас. Поддержка контроллера, тип накопителя, задержка записи, rebuild и требования приложения должны соответствовать. Не переносите обычную дисковую формулу на любую распределённую архитектуру: репликация, erasure coding и резерв восстановления имеют свои условия. Для сравнения нужна полезная ёмкость завершённой схемы, а не только число накопителей в корпусе.
IOPS, размер блока и задержка: как проверять storage для ВМ?
Тест должен отражать чтение/запись, случайность, размер блока, число задач и рабочий набор. Последовательное чтение большого файла не описывает базу с мелкой смешанной записью. Пиковый результат SSD не гарантирует устойчивую работу массива при полной заполненности, очистке, отказе и восстановлении. Для критичного сервиса измеряют задержку операций и время приложения вместе с IOPS.
Допустим, профиль задаёт 40 000 операций по 8 КиБ: полезный объём равен 327,68 МБ/с. Если на том же пути одновременно идёт backup 600 МБ/с, суммарный заданный throughput уже около 927,68 МБ/с до расходов. При этом storage должен выдерживать и требуемую задержку мелких операций. Высокая средняя полоса не компенсирует длинные паузы интерактивной базы.
| Storage-сценарий | Что измерять | Почему отдельный тест |
|---|---|---|
| Мелкая смешанная нагрузка | IOPS и задержку | База и интерактивные сервисы |
| Большие последовательные данные | Устойчивые МБ/с | Файлы и backup |
| Обе нагрузки вместе | Конкуренцию и хвост задержек | Реальный рабочий пик |
| Отказ накопителя/rebuild | Доступность и восстановительную нагрузку | Аварийный профиль |
Для ресурса записи смотрите применимые DWPD/TBW и реальные данные записи накопителя, а не только логический поток приложения. В условном расчёте 1 DWPD для SSD 3,84 ТБ на пять лет соответствует 3,84 × 365 × 5 = 7008 ТБ записей. Это объяснение метрики, не характеристика любого Cisco SSD. Усиление записи, схема защиты и распределение нагрузки меняют ресурс конкретных устройств.
Запишите интерфейс, контроллер, кэш, защиту кэша, firmware и поддерживаемые диски. Внешне похожий накопитель не подтверждает пригодность для выбранного UCS и гипервизора. Если питание или контроллер откажет, поведение записи должно соответствовать требованиям целостности. Такие условия не заменяются синтетической максимальной цифрой throughput.
Какой резерв сети нужен для storage, migration и backup одновременно?
Разделите логические роли и физические пути. Несколько VLAN на одном NIC дают политики, но не независимые интерфейсы и не дополнительную полосу. Management, рабочие ВМ, storage, миграция и backup могут конкурировать. Для резервирования проверьте поддержку адаптера, сервера, коммутаторов и гипервизора. Два порта в один общий узел не покрывают его отказ.
Учебный хост требует 8 Гбит/с рабочей передачи, 6 Гбит/с storage и 4 Гбит/с фоновых задач в выбранном пике. Сумма — 18 Гбит/с полезной нагрузки. При потере одного из двух 25G-путей оставшийся имеет номинальные 25G, но нужны расходы и распределение. Если storage и migration иногда создают больший общий поток, его тоже включают в сценарий N−1, а не ограничиваются этим средним заданием.
| Роль сети | Что предусмотреть | Аварийная проверка |
|---|---|---|
| Управление | Доступ к хосту и управлению | Администратор не теряет необходимый путь |
| Рабочие ВМ | Профиль приложений и политика | Обязательные операции продолжаются |
| Storage | Поддерживаемый multipath/проект | Данные доступны на оставшемся пути |
| Migration | Окно и разрешённая полоса | Не нарушает рабочие приложения |
| Backup | Скорость, расписание и восстановление | Не исчерпывает резерв без необходимости |
Не суммируйте два NIC для одного потока без проверки соответствующей технологии. Multipath storage, teaming и LACP имеют разные условия. Jumbo frames также требуют согласованного пути и измеримой пользы. Для выбора кабеля и модулей используйте проверку оптической совместимости Cisco, а в серверной спецификации включите обе стороны и все необходимые компоненты.
Три хоста и HA: почему свободные CPU/RAM не гарантируют запуск ВМ?
После отказа данные ВМ должны оставаться доступны, а правила размещения — позволять их запуск. Локальный диск умершего хоста не становится доступным соседям из-за свободной памяти. Нужна выбранная архитектура хранения и подтверждённый путь. Устройства passthrough, GPU, лицензии и affinity также способны ограничить перенос. Состав HA проверяют для каждой критичной ВМ.
Обычный перезапуск ВМ после отказа не равен непрерывному выполнению приложения. Для базы могут потребоваться восстановление и собственные механизмы доступности, а пользовательская сессия — переподключиться. Определите RTO/RPO как требования проекта и испытайте их. Наличие гипервизорного HA само по себе не гарантирует нулевой перерыв или отсутствие любой потери последнего состояния приложения.
Проверьте порядок старта, зависимости и размещение нескольких копий сервиса. Две ВМ одного критичного приложения на одном хосте сохраняют общий риск. Правила разнесения должны работать и после отказа. Для обслуживания кластера учитывают, что один узел уже выведен, а дополнительная авария уменьшает ресурсы ещё раз. N+1 не следует трактовать как покрытие любой одновременной комбинации отказов.
Как проверить HCL и firmware до заказа NIC, дисков и гипервизора?
Совместимость — это конкретная связка: сервер, CPU, адаптер, контроллер, накопитель, firmware, драйвер и выпуск гипервизора. Поддержка базового UCS не подтверждает произвольную карту из той же категории. Сохраните точные позиции и применимую матрицу в спецификации. Если используется управление через Fabric Interconnect или другой UCS режим, его компоненты также входят в проверку.
| Компонент | Что фиксировать | Риск пропуска |
|---|---|---|
| Хост | PID, CPU, вариант шасси | Неподдерживаемая комбинация |
| NIC/VIC | Модель, firmware, драйвер | Проблема сети или функции виртуализации |
| Storage | Контроллер и диски | Ошибки пути и неподходящая поддержка |
| Гипервизор | Точный выпуск и build | Неравноценность общего имени продукта |
| Управление UCS | Режим и выпуски компонентов | Несовместимость эксплуатации |
Перед обновлением подготовьте путь изменения всей связки. Новая firmware адаптера при старом драйвере не обязана быть лучшей конфигурацией. Сначала испытайте репрезентативный узел и рабочие функции, затем разворачивайте по плану. Сохраняйте возможность возврата и ограничения миграции. Само слово «последняя версия» не заменяет подходящую поддерживаемую комбинацию.
Как сравнить C-Series и X-Series по полному инфраструктурному комплекту?
Rack-сервер и вычислительный модуль имеют разный состав готового решения. Для C-Series проверяют нужный режим управления и сетевые подключения. Для X-Series в расчёт входят соответствующие шасси, Fabric Interconnect, модули, питание и управление. Цена одного compute node не описывает инфраструктуру, в которой он сможет работать. Если часть уже есть, проверьте её совместимость и свободные ресурсы.
Сравните число узлов, рост, обслуживание и общий риск. Несколько rack-серверов могут быть удобны для самостоятельной небольшой инфраструктуры; модульный вариант — для подходящего масштаба и существующей UCS архитектуры. Это не универсальное правило выбора. Нужны полный комплект и стоимость эксплуатации. Свободное место в шасси не заменяет питание, доступные порты и нужные права.
| Позиция сравнения | C-Series | X-Series |
|---|---|---|
| Базовая вычислительная часть | Полный rack-сервер | Подходящий compute node |
| Подключение | Нужные NIC/VIC и сеть | Соответствующая инфраструктура шасси и FI |
| Питание | Комплект сервера и стойки | Общий поддерживаемый ресурс системы |
| Управление | Выбранный поддерживаемый режим | Полный режим UCS архитектуры |
| Расширение | Узлы и компоненты | Слоты плюс ресурсы всей системы |
Для кандидатов используйте каталог UCS C-Series и UCS X-Series. Попросите показать одинаковые CPU/RAM, полезную storage ёмкость и аварийную нагрузку. Тогда сравнение будет относиться к завершённому кластеру, а не к внешне разным ценам неполных узлов.
Как провести пилот UCS и принять виртуализацию под реальную нагрузку?
Как сравнить CPU с разным числом ядер вместе с лицензиями?
В условном трёхузловом кластере по два CPU с 24 ядрами дают 144 физических ядра, а вариант с 32 — 192. Разница составляет 48 ядер, или 33,3%. Если конкретное ПО лицензируется по физическим ядрам, это может менять программный бюджет. Но реальную стоимость определяют условия продукта, минимумы и коммерческое предложение; она не обязана расти точно на тот же процент.
Большее число ядер полезно только если оно соответствует рабочему профилю. Проверьте производительность на ядро, масштабирование приложения, память и режим после отказа. Две конфигурации могут иметь разный результат у базы и у большого числа лёгких ВМ. Нельзя выбрать меньше ядер только ради лицензии, если приложение не выполняет требование; нельзя и считать самый большой CPU выгодным без проверки.
| Вариант примера | Физические ядра кластера | Что сравнить дополнительно |
|---|---|---|
| 3 × 2 CPU × 24 ядра | 144 | Приложения и лицензии |
| 3 × 2 CPU × 32 ядра | 192 | Дополнительную пользу и стоимость |
| Один хост недоступен | 96 или 128 соответственно | Обязательную нагрузку на оставшихся |
Запросите одинаковый срок, поддерживаемые CPU, память и программный комплект. Для гипервизора, базы и других приложений могут быть разные метрики. Аппаратная цена сервера без этих позиций не показывает полную стоимость виртуализации. Сохраните применимые условия в BOM, не подставляя универсальную ставку на ядро для всех продуктов.
HA, snapshots и backup: какие разные задачи нужно проверить?
HA помогает восстановить нагрузку после предусмотренного отказа, snapshots фиксируют соответствующее состояние, а backup нужен для выбранных сценариев восстановления данных. Эти механизмы не заменяют друг друга автоматически. Если оператор удалил данные или приложение записало неправильное состояние, доступный кластер может продолжать обслуживать именно его. Нужны отдельные требования RPO/RTO и проверенные копии.
В пилоте восстановите одну репрезентативную ВМ и её приложение в разрешённой тестовой среде. Проверьте целостность, зависимые сервисы, сеть и время возвращения операции. Успешная запись задания backup не подтверждает, что восстановленный сервис действительно работает. Для базы нужны предусмотренный консистентный способ и проверка результата, а не только наличие файлов копии.
| Механизм | Проверяемая цель | Что не подтверждает сам факт наличия |
|---|---|---|
| HA | Восстановление после нужного отказа | Защиту от любой ошибки данных |
| Snapshot | Предусмотренное состояние и возврат | Полноценную независимую копию |
| Backup | Проверенное восстановление сервиса | Пригодность без restore-теста |
Считайте storage и сеть для восстановления одновременно с рабочими нагрузками. Большая копия может занять ресурс в самый неподходящий момент. Разместите копии в предусмотренной независимой области и проверьте доступ к ним при отказе исходного хоста или другой выбранной причины. В проекте должно быть понятно, какие данные и в какой срок возвращаются.
Передайте эксплуатационной команде инструкции восстановления, матрицу совместимости и измерения пилота. Обновляйте их после изменения CPU, DIMM, NIC, firmware или гипервизора. Тогда конфигурация UCS останется проверяемой после модернизации, а следующий закупочный этап будет опираться на фактические ограничения и рабочую нагрузку.
Запускайте репрезентативные приложения, а не только одинаковые пустые ВМ. Сохраняйте конфигурации и рабочий набор. Затем проверяйте фоновые задачи, пиковое событие, отказ и восстановление. В отчёте должны быть CPU/scheduling, RAM, storage latency, сеть и время бизнес-операции. Высокий synthetic score одного ресурса не подтверждает завершённый результат.
| Тест | Показатель | Что подтверждает |
|---|---|---|
| Рабочие приложения | Время и корректность операции | Пригодность конфигурации |
| Backup/migration вместе | Конкуренцию и задержку | Реальный общий профиль |
| Отказ одного хоста | Запуск, размещение и данные | Требуемый N+1 |
| Storage-отказ при применимости | Путь, rebuild и latency | Согласованную доступность данных |
| Возврат и обслуживание | План восстановления и перемещения | Эксплуатационную готовность |
Для подбора UCS под виртуализацию отправьте ведомость ВМ, измерения, гипервизор, хранение и аварийные требования. Запросите полный BOM с совместимостью, лицензиями и работами. Полезная конфигурация должна одновременно решать задачу приложения, доступности и расширения, а не только иметь большой CPU или максимальную RAM.
Частые вопросы о сервере для виртуализации
Сколько ВМ помещается на UCS?
Зависит от нагрузки и ресурсов. Универсального числа нет; нужно считать CPU, RAM, storage, сеть и отказ отдельно.
Можно ли считать vCPU физическими ядрами?
Нет. vCPU — выделяемый виртуальный ресурс, его нагрузка и планирование отличаются. Требуются измерения приложений.
Достаточно ли большого объёма RAM?
Нет. CPU, storage и сеть способны ограничить систему независимо от памяти.
Три хоста автоматически дают N+1?
Только если оставшиеся два способны принять нужные ВМ и данные доступны. Проверяют ресурсы и ограничения размещения.
Можно ли использовать любые SSD?
Проверяют аппаратную и программную совместимость, ресурс записи и профиль нагрузки. Название интерфейса не подтверждает пригодность.
Как учесть рост на три года?
Привяжите рост к новым ВМ, данным и приложениям. Затем проверьте поддерживаемый путь расширения и ресурсы после отказа.
UCS C240 M7 можно включить в ведомость кандидатов. Перед заказом проверьте полное исполнение и соответствие описанному сценарию; наличие карточки не заменяет проверку комплекта.
Как выбрать и купить Cisco UCS для виртуализации?
Передайте ведомость ВМ, измерения нагрузки, гипервизор, способ хранения, сеть и требования HA через форму подбора. Попросите полную спецификацию CPU, DIMM, накопителей, контроллеров, NIC, firmware и программных прав. Готовая конфигурация должна отвечать нормальному режиму и согласованному отказу.