Подключение Dell PowerStore к Cisco Nexus: настройка iSCSI, multipath и проверка отказов
Подключение Dell PowerStore к Cisco Nexus по iSCSI состоит из трёх согласованных частей: сети Ethernet, настроек блочного хранилища и управления путями на сервере. Коммутатор передаёт пакеты, СХД предоставляет том нужному инициатору, а MPIO или Linux multipath объединяет доступные пути к этому тому. Если пропустить один уровень, диск иногда будет виден и даже покажет хорошую скорость, но исчезнет после отказа кабеля, перезагрузки сервера или обновления контроллера.
В этом руководстве разберём подключение с двумя сетями хранения, расчёт числа путей, ALUA, VLAN, MTU и LACP, затем пройдём настройки Windows Server, Linux, Proxmox VE и VMware ESXi. Отдельные разделы посвящены диагностике, миграции и испытаниям. Цель — получить проверяемую схему доступа к данным, которую можно включить в техническое задание и воспроизвести после замены оборудования.
Основной пример рассчитан на один двухузловой массив PowerStore, три сервера и два независимых коммутатора хранения. Адреса, нагрузки и количества в примере условные. Точные номера портов, совместимость и политики хоста уточняют для выбранной модели PowerStore, версии PowerStoreOS, Cisco NX-OS и операционной системы. Для файловых сервисов, нескольких массивов и Metro нужны дополнительные условия; переносить на них блочную схему целиком нельзя.
Как подключить Dell PowerStore к Cisco Nexus: короткий порядок действий
Для устойчивого доступа по iSCSI нужны несколько проверенных путей к одному тому, а не просто несколько включённых кабелей. До настройки составьте таблицу: какой интерфейс сервера видит какой IP-портал СХД, через какой Cisco проходит соединение и что останется доступным при отказе каждого компонента. Эта таблица связывает физический монтаж с тем, что затем покажет MPIO.
- Зафиксируйте модель и поколение PowerStore, релиз ПО, интерфейсные модули, NIC серверов и поддерживаемый стек хоста.
- Выберите топологию. Для нашего примера это две отдельные подсети хранения A/B с доступом к обоим узлам СХД через каждую сеть.
- Согласуйте VLAN, адреса, MTU, скорость и FEC, затем подпишите кабели и порты.
- Создайте сети хранения на PowerStore и проверьте доступность каждого портала с правильного исходного интерфейса сервера.
- Зарегистрируйте IQN инициаторов, создайте тестовый том и сопоставьте его нужным хостам или группе.
- Настройте поддерживаемое управление путями: MPIO, DM-Multipath либо стек гипервизора. Проверьте единый идентификатор тома.
- Выполните испытания отказов, перезагрузки и возврата оборудования под согласованной нагрузкой.
Рабочий результат включает схему, адресный план, параметры хоста и отчёт о тестах. Снимок экрана с четырьмя путями полезен, но он не доказывает, что пути физически независимы или что приложение переживёт переключение. Это устанавливается отдельной проверкой, при которой видны изменения сессий, состояние тома и прикладные операции.
Что меняется с обновлением PowerStore и почему сначала проверяют поколение?
Ускорение накопителей и контроллеров меняет требования к внешней сети. Массив может обслуживать больше параллельных запросов, а старый сетевой путь остаётся прежним. Поэтому при обновлении PowerStore проверяют серверные NIC, коммутаторы, кабели и оставшуюся после отказа полосу. Сравнивать только число терабайт и название процессора недостаточно: приложение обращается к данным через конкретный набор соединений.
В PowerStore Gen 3 используются модели 1500, 5500 и 9500 в двухузловом корпусе 3U. Новое поколение меняет конструкцию, интерфейсные модули и организацию внутреннего обмена. Его внутренние RDMA-соединения между узлами не являются готовыми портами доступа для серверного iSCSI. При проектировании внешнего подключения смотрят именно фронтенд-модули и поддерживаемые ими протоколы.
Материал о новом оборудовании помогает правильно поставить вопросы: где находится клиентский интерфейс, что резервируется внутри массива, какие модули можно установить и как обслуживается узел. Ответ о внешней сети всё равно требует проверки совместимости с Cisco и выбранным хостом. Нельзя принять скорость внутреннего канала СХД за скорость одного серверного подключения или автоматически перенести кабельную схему предыдущего поколения.
На действующем объекте рядом могут находиться PowerStore 1200T, 3200T и более новые системы. Для них полезно вести раздельные паспорта конфигурации. В каждом указывают модель, релиз, модули, физические порты и назначение сетей. Так специалист, который придёт на обслуживание через год, сможет отличить допустимое изменение от изменения архитектуры. Предположение «все PowerStore подключаются одинаково» особенно опасно для агрегированных интерфейсов и служебных кластерных сетей.
iSCSI, Fibre Channel, NFS или NVMe/TCP: какой протокол здесь нужен?
iSCSI переносит команды SCSI через TCP/IP. Сервер выступает инициатором, а массив предоставляет целевые устройства и логические тома. Для приложений это блочный доступ: хост получает устройство, поверх которого работает файловая система, менеджер томов или хранилище гипервизора. Ethernet-коммутатор Cisco Nexus в такой схеме не обязан понимать содержимое SCSI-команды; он должен корректно передавать IP-трафик с нужными характеристиками.
| Протокол | Что получает хост | Сеть и управление путями | Граница применения |
|---|---|---|---|
| iSCSI | Блочное SCSI-устройство | Ethernet/IP, MPIO или соответствующий multipath-стек | Нужна поддержка конкретной ОС, массива и конфигурации |
| Fibre Channel | Блочное устройство через FC SAN | FC HBA, отдельные фабрики и поддерживаемые SAN-коммутаторы | Обычный Ethernet-порт Nexus не заменяет FC-порт Cisco MDS |
| NFS | Файловое хранилище | Ethernet/IP, правила NAS-подключения и выбранной версии NFS | Схему iSCSI MPIO нельзя считать инструкцией для NFS |
| NVMe/TCP | NVMe-устройство по TCP/IP | Ethernet, NQN и NVMe multipathing/ANA | Нужны поддерживаемые версии ПО и отдельная процедура подключения |
Слова SAN и NAS описывают разные способы предоставления хранения. SAN не обязательно означает Fibre Channel: iSCSI тоже строит сеть блочного доступа. При этом покупка Ethernet-коммутатора с быстрыми портами сама по себе не определяет, будет подключение iSCSI или NVMe/TCP. Протокол должен поддерживаться и массивом, и хостом, а необходимые функции — входить в выбранную конфигурацию.
Дальше основной разбор относится к iSCSI. Fibre Channel и NVMe/TCP рассматриваются как отдельные варианты развития. Для одного хоста не следует одновременно открывать один и тот же блочный ресурс PowerStore через разные протоколы, рассчитывая получить ещё больше путей. Смена протокола — отдельная миграционная процедура с проверкой идентичности устройства и поддерживаемого способа переключения.
Что означают IQN, портал, LUN, сессия и путь?
IQN — имя iSCSI-узла. У инициатора оно помогает определить, какой именно хост запрашивает доступ. IP-адрес при этом отвечает за сетевую достижимость, а не заменяет идентичность инициатора. После клонирования образа сервера нужно убедиться, что клон получил собственное корректное имя: случайно повторённые IQN затрудняют сопоставление доступа и диагностику.
Портал — сетевая точка подключения к target, обычно IP-адрес и TCP-порт 3260. Один target может быть доступен через несколько порталов. Установленная сессия показывает, что инициатор вошёл в target, но ещё не доказывает доступность нужного тома: том может быть не сопоставлен хосту, иметь другое назначение или не распознаваться верхним уровнем хранения.
LUN часто называют сам предоставленный логический диск. Строго говоря, номер LUN участвует в адресации логического устройства в определённом контексте. Для устойчивой идентификации следует дополнительно использовать постоянный идентификатор устройства — например, WWID в Linux. Имя /dev/sdc или номер «Диск 3» в Windows могут измениться после перезагрузки и не должны служить единственным основанием для автоматического форматирования или монтажа.
Путь связывает инициатор, сеть и конкретный целевой порт с одним логическим устройством. Несколько путей к одному WWID не создают несколько независимых дисков и не увеличивают ёмкость. Именно эту ситуацию должен распознать multipath. В рабочей ведомости отдельно учитывают число физических линий, IP-порталов, сессий и путей к каждому тому. Эти числа связаны топологией, но не обязаны совпадать.
Какие советы по PowerStoreOS устарели: LACP и системный bond
Перед использованием готового конфигурационного примера проверьте его релиз и назначение портов. В PowerStoreOS менялись возможности пользовательской агрегации и создание системного bond. Старый совет иногда остаётся верным для определённого оборудования и одновременно становится неверным как общее правило для всей линейки.
| Условие | Что учитывать | Практический вывод |
|---|---|---|
| Пользовательские агрегаты до PowerStoreOS 4.0 | Возможности отличались от последующих релизов; NAS и системные связи имели свои правила | Не переносить ограничения старого примера на новое ПО без проверки |
| PowerStoreOS 4.0 и новее | Пользовательские LACP-агрегаты могут обслуживать iSCSI и репликацию | Утверждение «PowerStore iSCSI никогда не работает через bond» неверно |
| Gen 1/Gen 2 с PowerStoreOS 4.3 и ранее | Первые порты четырёхпортовой карты автоматически участвовали в системном bond | Сначала установить роль существующих портов, затем менять кабели |
| Первичное развёртывание с PowerStoreOS 4.4 и новее | Агрегаты по умолчанию не создаются; для многомассивной кластерной связи выбирают нужный bond | Не ожидать, что прежняя автоматическая конфигурация появится сама |
Поддержка iSCSI на агрегате со стороны массива не означает, что любую серверную teaming-схему можно использовать с любым программным инициатором. Например, ограничения VMware software iSCSI относятся к хостовой стороне. Эти условия нужно совместить в одном проекте, а не выбрать из двух руководств более удобное предложение.
Если схема построена на отдельных iSCSI-портах, наличие в релизе функции LACP не обязывает её включать. Аналогично, если выбран поддерживаемый bond, он не отменяет проверку путей к обоим узлам массива. Архитектуру выбирают осознанно, затем поддерживают её последовательно на СХД, Cisco и хостах. Произвольное смешение двух корректных схем часто даёт некорректный результат.
Какие данные собрать до заказа PowerStore и Cisco?
Соберите паспорт хоста: модель сервера, слот и артикул NIC, firmware, драйвер, операционная система, обновления и используемый DSM или multipath-стек. Для виртуализации добавьте версию гипервизора и тип хранилища для ВМ. Поддержка сетевой карты в обычном Linux не равна поддержке всей конфигурации конкретной платформой виртуализации.
Для PowerStore запишите модель, поколение, текущий и целевой релиз, режим развёртывания, установленные I/O-модули и существующие назначения портов. Для Cisco — точную модель Nexus, режим работы, версию NX-OS, оптику, лицензии и функции, которые реально нужны в проекте. Одинаковая скорость двух портов не подтверждает совместимость модулей, FEC и кабельной сборки.
Полезно хранить подтверждение совместимости вместе с датой и версиями, для которых оно получено. Проверка «сервер поддерживается» без указания NIC и драйвера быстро теряет смысл. Если поставщик предлагает замену одного компонента, нужно понять, влияет ли она на поддержку или требует повторного теста. Особенно внимательно оценивают адаптеры, контроллеры и нестандартные кабели.
Для предварительного сравнения аппаратной части используйте каталог систем хранения Dell PowerStore и коммутаторы Cisco Nexus 9000. Каталог помогает определить кандидатов; окончательная спецификация должна описывать точную комплектацию и поддерживаемый стек. Наличие подходящего названия в карточке не заменяет эту проверку и не подтверждает текущую складскую доступность.
Какие требования к приложению записать в ТЗ?
Требования к сети хранения формулируют через работу приложения. Укажите полезную ёмкость, рост, профиль I/O, пиковые IOPS, размер блока, долю записи и допустимую задержку. Отдельно задайте условия для обычного режима, отказа одного элемента и восстановления. Если после потери коммутатора допустимо снижение производительности, размер этого снижения нужно согласовать заранее.
Например, для тестового проекта можно поставить условие: при штатной нагрузке p95 задержки конкретной операции приложения не выше выбранной границы, а при отказе одного пути нет ошибок записи и непредусмотренного перезапуска сервиса. Границу выбирают вместе с владельцем приложения. Она не должна появляться как случайное число из обзора массива или рекламного теста с другим профилем дисковых операций.
Согласуйте также длительность паузы, которую выдерживают файловая система, база данных и кластерное ПО. Сохранение TCP-соединения, восстановление пути и готовность прикладной транзакции — разные события. В отчёте нужно видеть их последовательность. Одна средняя задержка за весь час испытаний может скрыть короткое, но неприемлемое зависание.
Для ёмкости фиксируйте единицы: ТБ или ТиБ, объём до или после защиты данных, резерв под снимки и допустимую заполненность. Обещание эффективной ёмкости зависит от данных и не заменяет исходный расчёт физического места. В сетевом проекте особенно важно знать объём, который реально потребуется передать при копировании, восстановлении или миграции: дедупликация на одном участке не гарантирует такое же сокращение потока на другом.
Как устроить две независимые сети iSCSI?
В основном примере у каждого сервера есть интерфейс хранения A и интерфейс хранения B. A подключён к Cisco A, B — к Cisco B. На PowerStore в каждой сети присутствует портал обоих узлов массива. Поэтому потеря одного коммутатора убирает одну сеть, но оставляет доступ через вторую к обоим контроллерным узлам. Полную независимость проверяют также по NIC, модулям, питанию и физическим трассам.
Между этими двумя сетями не требуется создавать общую iSCSI-подсеть. Каждая имеет собственную адресацию и VLAN. Если выделенные коммутаторы вообще не соединены между собой, одна и та же подсеть не должна создавать ожидание сквозной доступности. В нашем примере маршрутизация между A и B не используется, а исходящий интерфейс хоста определяется соответствующей сетью.
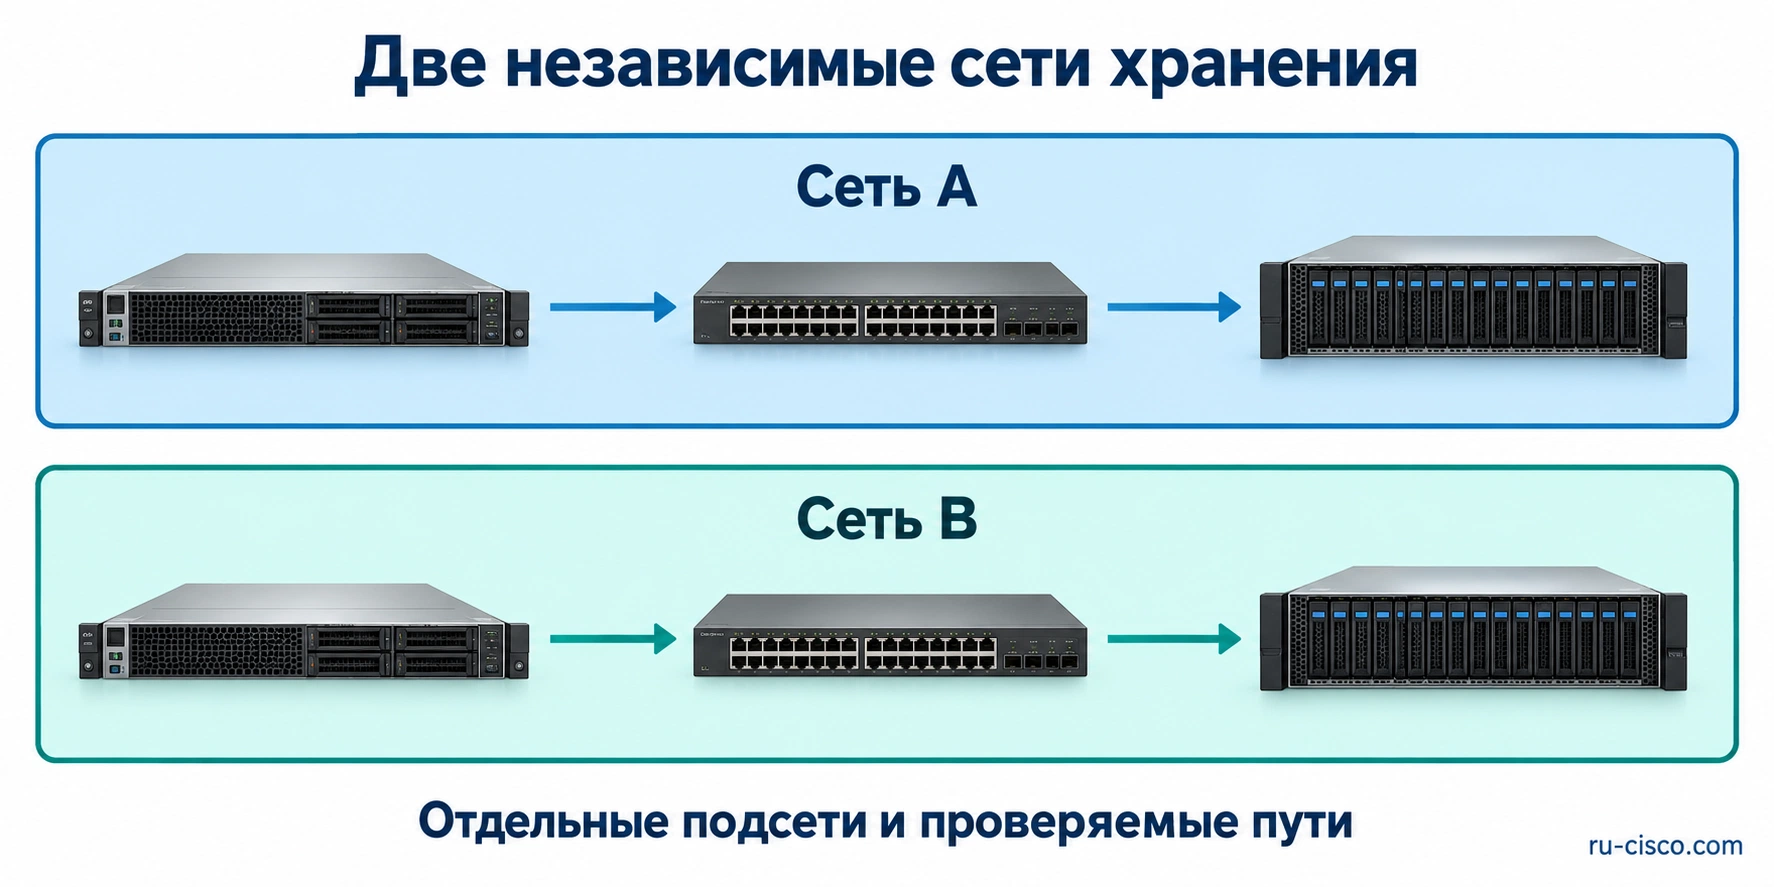
Независимые iSCSI-сети могут существовать и на общей коммутаторной инфраструктуре, но тогда нужно явно перечислить общие компоненты. Два VLAN одного Cisco не защищают от отказа самого Cisco. Два порта одной карты не защищают от отказа карты. Если обе сети зависят от одного блока питания или сетевого модуля, эти зависимости должны быть видны в схеме отказов.
PowerStore может выдавать сетевые предупреждения для некоторых вариантов с независимыми коммутаторами. Такое предупреждение разбирают по фактической кабельной схеме и применимому сценарию поддержки. Автоматически игнорировать все сообщения нельзя; автоматически переделывать правильную схему в другую тоже не стоит. Основанием служит проверенная матрица доступности и подтверждённое поведение при отказе.
Как составить адресный план, чтобы не потерять половину путей?
Возьмём две условные сети: A — 10.30.110.0/24, VLAN 110; B — 10.30.120.0/24, VLAN 120. На первом сервере интерфейсы получают адреса 10.30.110.11 и 10.30.120.11. На следующем — окончания .12, на третьем — .13. У обоих узлов СХД есть по одному порталу в каждой сети.
| Объект | Сеть A / VLAN 110 | Сеть B / VLAN 120 | Назначение |
|---|---|---|---|
| Хост 1 | 10.30.110.11/24 | 10.30.120.11/24 | Исходные интерфейсы iSCSI |
| Хост 2 | 10.30.110.12/24 | 10.30.120.12/24 | Исходные интерфейсы iSCSI |
| Хост 3 | 10.30.110.13/24 | 10.30.120.13/24 | Исходные интерфейсы iSCSI |
| Узел СХД 1 | 10.30.110.101/24 | 10.30.120.101/24 | Целевые порталы |
| Узел СХД 2 | 10.30.110.102/24 | 10.30.120.102/24 | Целевые порталы |
В этой локальной схеме хосту не нужен маршрут через шлюз для обращения к порталам собственной подсети. Административная сеть остаётся отдельной. Если в проекте используется маршрутизируемый storage-доступ, его нужно рассмотреть отдельно: доступность при отказе маршрутизатора, MTU, ACL, асимметрия маршрутов и поддержка такого подключения хостовым стеком. Приписать всем интерфейсам одинаковый default gateway недостаточно.
На Cisco согласуйте способ передачи VLAN. Если хост отправляет нетегированный трафик через отдельную физическую NIC, порт часто настраивают как access в нужном VLAN. Если тегирование выполняет хост или VLAN-интерфейс, требуется соответствующий trunk. Номер VLAN в настройках ОС и режим порта коммутатора должны описывать одну схему; двойное тегирование или отсутствие нужного VLAN приводит к частичной доступности.
Номера 110/120 и выбранные сети — только пример. Перед применением сравните их с действующей адресацией, резервированием IP, ACL и средствами мониторинга. Для каждой строки дополнительно запишите MAC, имя NIC, фактический порт Cisco и порт СХД. Такой документ помогает обнаружить кабельную ошибку без догадок по цвету провода.
Сколько путей должно быть к одному тому и что показывает ALUA?
У первого хоста из примера есть две достижимые пары в сети A: его адрес .110.11 соединяется с порталами .110.101 и .110.102. В сети B есть ещё две пары: .120.11 соединяется с .120.101 и .120.102. Если созданы нужные сессии и том сопоставлен правильно, ожидается четыре пути к одному устройству. На трёх хостах получится двенадцать хостовых путей к этому общему тому, но на каждом отдельно по-прежнему проверяют четыре.
ALUA сообщает хосту, какие пути являются оптимизированными для данного логического устройства. У PowerStore есть привязка тома к узлу, который обеспечивает предпочтительное обслуживание. Поэтому четыре обнаруженных пути не обязательно должны одновременно переносить одинаковый объём I/O. Путь с состоянием active/non-optimized может быть рабочим резервным маршрутом, а не неисправностью.
Проверяют три вещи: все пути ведут к одному постоянному идентификатору тома; есть доступ к обоим узлам СХД; оставшиеся пути действительно работают после согласованного отказа. Число строк в выводе команды без этих проверок мало что говорит. Восемь дублирующихся соединений через один адаптер могут давать меньше защиты, чем четыре правильно разведённых пути.
Пределы и рекомендации по числу путей уточняют для выбранного хоста и релиза. Не следует открывать все комбинации исходных и целевых адресов только ради большого числа: это увеличивает объём служебного обмена, время обнаружения и сложность диагностики. Увеличение числа путей оправдывают конкретной топологией или требованиями масштабирования, а не предположением, что каждый новый путь автоматически добавляет скорость.
Чем MPIO отличается от LACP и можно ли использовать их вместе?
LACP объединяет Ethernet-линии в логический канал. MPIO управляет путями к блочному устройству. У этих механизмов разные уровни отказа и разные идентификаторы. Агрегат знает о своих участниках, но не определяет, какой том открыт хосту и какой узел СХД предоставляет оптимизированный путь. Multipath, наоборот, не исправляет отсутствующий VLAN и не превращает два неправильно настроенных кабеля в рабочий port-channel.
В некоторых поддерживаемых проектах оба механизма присутствуют одновременно. Со стороны PowerStoreOS 4.0 и новее iSCSI может использовать пользовательские агрегаты. При этом хосту по-прежнему нужны корректные пути к ресурсу и допустимая конфигурация инициатора. У VMware software iSCSI есть ограничения на хостовую агрегацию и port binding, которые нельзя отменить фактом поддержки bond на массиве.
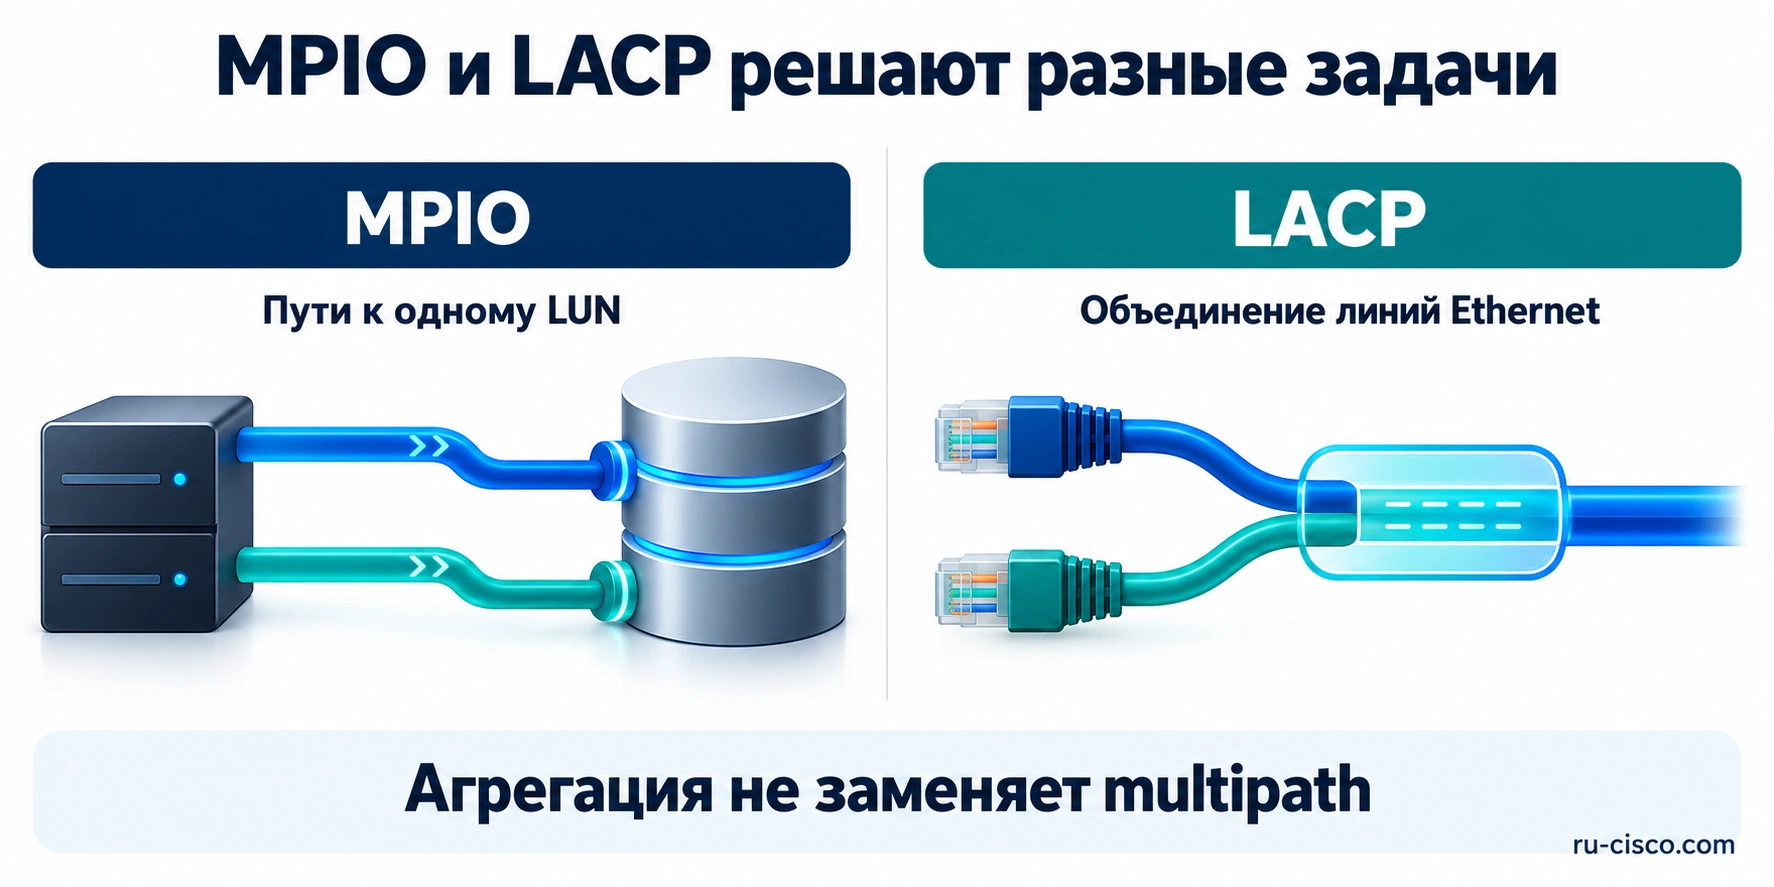
Один TCP-поток в обычной хешируемой агрегации не получает сумму скоростей всех участников. Если четыре линии по 25 Гбит/с образуют агрегат, отдельная сессия может остаться ограниченной одной линией. Другие сессии распределятся по участникам в зависимости от хеша и фактических параметров соединений. Поэтому тест одного потока и тест нескольких потоков отвечают на разные вопросы.
В нашем базовом варианте используются отдельные интерфейсы хранения и независимые сети A/B. Это делает матрицу путей прозрачной, но не является запретом на любую другую схему. При сравнении вариантов запишите, от каких отказов защищает каждый механизм, кто управляет переключением и как это проверяется на выбранном стеке. Название функции в спецификации должно сопровождаться её ролью.
Нужен ли vPC между двумя Cisco для iSCSI?
Не для каждого проекта. Если A и B — независимые iSCSI-сети, а серверный multipath работает через отдельные интерфейсы и подсети, наличие vPC не является автоматическим условием доступа к данным. В таком проекте не нужно создавать port-channel только потому, что установлены два коммутатора одного производителя.
Если выбран агрегат, распределённый между двумя Nexus, необходимо поддерживаемое объединение на уровне пары — например, vPC в соответствующем режиме и релизе. Обычный LACP не позволяет двум совершенно независимым коммутаторам произвольно выдавать себя за одного партнёра. Пара должна иметь согласованные параметры, необходимые связи и определённое поведение при частичном отказе.
Для vPC различают peer-link и peer-keepalive. У них разные задачи; один не заменяет другой. Проект проверяют при потере отдельного участника, всей межкоммутаторной связи и одного peer. Конкретные реакции зависят от конфигурации и подключённых устройств. Нельзя проверить только выключение одного кабеля к серверу и считать всю пару испытанной.
Смешанная инфраструктура требует особенно аккуратного описания. Пара Nexus может обслуживать агрегированные сети ВМ и одновременно отдельные порты iSCSI. Ведомость должна показывать, какие интерфейсы принадлежат port-channel, какие работают отдельно и где проходит каждый VLAN. Вводить одинаковые настройки на все порты «для единообразия» не следует: единообразие должно соответствовать роли соединения.
Почему нельзя путать iSCSI, управление, NAS и кластерные сети PowerStore?
У одного массива несколько видов связи. Клиентский iSCSI переносит команды и данные между хостом и томом. Административная сеть открывает интерфейс управления и служебные сервисы. NAS предоставляет файловые ресурсы. В многомассивной конфигурации PowerStore сети ICM и ICD обеспечивают обмен внутри кластера СХД. У каждой роли свои требования, даже если физические интерфейсы могут использоваться совместно.
Именно поэтому старый пример настройки Nexus с native VLAN, IPv6 и обязательным port-channel нельзя автоматически считать инструкцией для каждого отдельного iSCSI-порта. Эти настройки могут относиться к кластерным связям и определённой версии PowerStore. Если изменить их без понимания роли, можно нарушить обнаружение или обмен между массивами, хотя обычный клиентский ping ещё будет проходить.
Для нашего однокорпусного примера отдельные сети A/B описывают только доступ к блочным томам. Если проект включает NAS или объединение нескольких appliances, соответствующие связи добавляют в схему отдельно. Независимые storage-сети при этом не освобождают от требований к служебному обмену. Их нельзя отменить аргументом «у нас для отказоустойчивости коммутаторы не соединяются».
В паспорте порта полезны три поля: физическое подключение, логическая роль и основание настройки для данного релиза. Например, один порт может быть отдельным блочным интерфейсом, другой — участником пользовательского bond, третий — административным. Сначала выясняют эти роли на действующем массиве, затем планируют изменение. Кабель с подходящим разъёмом не является взаимозаменяемым только потому, что его можно переставить в соседнее гнездо.
MTU 1500 или 9000: как проверить весь путь?
iSCSI может работать с обычным MTU. Jumbo frames иногда уменьшают долю служебных операций на крупном потоке, но их преимущество зависит от нагрузки и реализации. Повышение MTU не добавляет полосу физической линии и не устраняет перегруженный контроллер. Решение принимают вместе с настройками хоста, массива и всех промежуточных устройств.
Если выбран IP MTU 9000, проверьте его на физической NIC, VLAN-интерфейсе, виртуальном коммутаторе и storage-интерфейсе. У Cisco допустимый размер Ethernet-кадра может задаваться другим числом, чем IP MTU конечного узла. VLAN-заголовок и особенности платформы учитывают отдельно. Нельзя бездумно скопировать одинаковое число во все поля, не выяснив, что именно измеряет каждое из них.
Для IPv4 тестовый ICMP payload 8972 байта вместе с обычными 20 байтами IP-заголовка и 8 байтами ICMP составляет IP-пакет 9000 байт. В Linux с iputils проверка конкретного пути может выглядеть так:
ping -I 10.30.110.11 -M do -s 8972 -c 4 10.30.110.101
Это пример для наших адресов и MTU 9000. Для MTU 1500 аналогичный размер полезной нагрузки — 1472 байта. Тест выполняют от нужного исходного адреса к каждому порталу, затем повторяют для сети B. Обычный ping без выбора источника может уйти через другой интерфейс и подтвердить не тот путь, который требуется проверить.
Если крупные пакеты не проходят, сравните границы сегмента, тегирование, ограничения интерфейсов и настройки виртуального слоя. Не используйте отключение запрета фрагментации как доказательство правильного jumbo-пути. Даже успешная проверка пакета нужного размера не измеряет скорость I/O: после неё остаются тесты потерь, нагрузки и приложения.
Как проверить NIC, SFP28, DAC и FEC до поиска ошибок в iSCSI?
Начните с физического уровня. Согласуйте поддерживаемую скорость порта, трансивер или кабельную сборку, длину, тип среды и FEC. У одинаково выглядящих SFP28-портов могут отличаться поддерживаемые режимы и требования к модулю. Для оптики проверяют оба конца соединения и среду между ними; для DAC — квалификацию сборки на обеих платформах.
Убедитесь, что NIC установлена в слот с достаточными линиями PCIe и доступна в выбранной конфигурации CPU. Сетевой адаптер с двумя 100G-портами не сможет гарантированно отдать их суммарную скорость через любой попавшийся слот. Ограничение может возникнуть до выхода пакета на коммутатор: на PCIe, NUMA-доступе, CPU хоста или в настройках драйвера.
На работающей линии смотрят не только состояние UP. Полезны CRC-ошибки, исправленные и неисправимые FEC-события, перезапуски линка, negotiated speed и параметры оптики. Рост исправленных ошибок сам по себе ещё не равен потере данных, но изменение их динамики помогает найти ухудшающийся кабель или соединение. Неисправимые ошибки и link flap требуют отдельного разбора.
Общие принципы выбора среды и расстояния разобраны в руководстве по оптическим модулям Cisco. В storage-проекте дополнительно проверяют квалификацию модулей со стороны Dell и NIC. Не обещайте совместимость исключительно по скорости и длине волны: точные артикулы, поддержка и версия ПО должны попасть в спецификацию.
Что проверить на Cisco Nexus перед подключением томов?
На этом этапе задача Cisco — обеспечить определённую схему передачи пакетов. Проверьте назначение физических портов, наличие VLAN, access/trunk, native VLAN там, где он требуется, допустимый MTU и состояние агрегатов, если они используются. Сравнивайте обе стороны пары и исходную кабельную ведомость. Порт с верным описанием, но неверным VLAN остаётся неверно настроенным.
Для NX-OS полезны команды просмотра. Конкретные имена интерфейсов и доступные варианты синтаксиса зависят от платформы и релиза; ниже показаны типичные диагностические формы:
show interface ethernet1/1
show interface ethernet1/1 counters errors
show interface trunk
show vlan brief
show port-channel summary
Снимите исходные счётчики до теста, затем посмотрите их изменение. Накопленная за год ошибка не доказывает причину текущего сбоя; быстро растущая ошибка во время нагрузки уже даёт связь со сценарием. При наличии нескольких очередей и QoS сравнивают нужный класс трафика и выходной интерфейс, а не только общий процент загрузки порта.
На коммутаторе не нужно включать случайные storage-функции только из-за слова iSCSI. Например, PFC, специальные flow-control-политики или повсеместная маршрутизация не являются универсальным предварительным условием TCP-доступа к массиву. Любое изменение должно решать конкретную задачу, соответствовать поддерживаемой архитектуре и проходить проверку. Базовую конфигурацию и сохранённые значения держите под контролем изменений, чтобы диагностика не превратилась в последовательность несвязанных экспериментов.
Как создать host mapping и проверить, что сервер видит нужный том?
После проверки сети зарегистрируйте хост на PowerStore с правильным типом ОС и его фактическими инициаторами. Сопоставьте IQN с паспортом сервера, а не с названием, придуманным вручную в интерфейсе СХД. Если хост переустанавливали, проверьте, не изменилось ли имя инициатора и не осталось ли старое сопоставление.
Для испытания создают отдельный том с понятным именем и назначением. Его сопоставляют только нужному хосту либо согласованной группе. Если том должен использовать кластер, доступность на нескольких хостах проектируют вместе с механизмом совместного владения. Обычную файловую систему нельзя безопасно писать с нескольких независимых серверов только потому, что СХД разрешила им увидеть одно устройство.
Проверка идёт по порядку: портал достижим, discovery возвращает ожидаемый target, сессии установлены от правильных источников, нужный том сопоставлен, идентификатор устройства совпадает на всех путях. Если один шаг не пройден, следующий не служит способом исправления. Например, повторное создание тома не устранит ошибку VLAN, а добавление ещё одного IQN не исправит выключенный multipathd.
Сохраните связь «имя тома → ID на СХД → WWID/серийный номер на хосте → назначение в гипервизоре». Это особенно полезно перед расширением, переносом и удалением ресурса. Человек, который видит только номер диска в ОС, не должен угадывать, какой производственный datastore за ним находится. Перед любыми операциями записи или форматирования идентичность подтверждают по нескольким независимым полям.
Как проверить iSCSI и MPIO в Windows Server?
На Windows Server заранее согласуют используемый DSM, поддержку массива и компоненты Multipath I/O. Несколько соединений в iSCSI Initiator ещё не означают, что том корректно принят MPIO. Нужно проверить, как Windows объединяет пути и какую политику применяет к устройству. Установка компонента и изменение claim-настроек могут требовать отдельного окна обслуживания и перезагрузки — это учитывают в плане.
В подключениях явно сопоставьте исходный storage-адрес с порталом соответствующей подсети. Для сети A это адреса 10.30.110.x, для B — 10.30.120.x. Ошибка с автоматическим выбором исходного интерфейса иногда создаёт несколько сессий через один и тот же физический путь. На экране их много, но потеря одной NIC обрывает всё подключение.
Get-IscsiTargetPortal
Get-IscsiSession
Get-IscsiConnection
Get-MSDSMAutomaticClaimSettings
mpclaim -s -d
Эти команды предназначены для просмотра состояния. Сопоставьте список соединений, целевые адреса и MPIO-диски с матрицей. Затем проверьте постоянство подключений после запланированной перезагрузки. Сессия, созданная вручную и не восстановившаяся при старте, даёт ложное ощущение готовности до первого обслуживания.
Для кластерного использования тома нужны соответствующие средства Windows Failover Clustering и поддерживаемая модель хранения. Не переводите один диск online на нескольких независимых узлах ради проверки видимости. В отчёте важно зафиксировать доступ на уровне storage-стека и корректную работу владельца ресурса. Политику распределения I/O выбирают для конкретного DSM и ALUA-поведения массива; название Round Robin само по себе не заменяет проверку поддержки.
Как проверить iSCSI и DM-Multipath в Linux?
В Linux разделяют задачи open-iscsi и multipath-tools. Первый обеспечивает обнаружение и подключение к iSCSI target, второй объединяет пути к одному устройству. Если настроена только первая часть, один том может появиться под несколькими именами /dev/sdX. Работать с каждым из них как с отдельным диском нельзя.
После установки поддерживаемых пакетов проверьте IQN, привязку к storage-интерфейсам и восстановление сессий. Затем убедитесь, что multipathd работает и распознаёт нужные устройства по WWID. Системный диск и другие неподходящие устройства не должны случайно попасть под новую универсальную политику. Используйте поддерживаемые настройки для выбранной ОС и массива, сохранив исходные значения.
cat /etc/iscsi/initiatorname.iscsi
iscsiadm -m session -P 3
multipath -ll
lsblk -o NAME,TYPE,SIZE,MODEL,SERIAL,WWN,MOUNTPOINTS
ip -s link show dev ens1f0
Имена интерфейсов и доступные поля lsblk зависят от дистрибутива; ens1f0 здесь пример. В выводе multipath проверяют единый WWID, группы путей, их состояние и принадлежность к ожидаемым порталам. Устойчивая ссылка на устройство должна переживать перезагрузку. Перестановка букв sdX не является поводом заново создавать файловую систему.
Особенно внимательно проверяйте поведение при потере всех путей. Бесконечное ожидание очереди может выглядеть как зависание процессов, а слишком короткий отказ — вернуть ошибку приложению раньше завершения штатного переключения. Значения no_path_retry, таймеров и политики failback согласуют как одну систему. Копирование одного параметра из старого multipath.conf не даёт предсказуемого результата на другой версии ядра и multipath-tools.
Как подключить PowerStore к Proxmox и не перепутать общий LVM с LVM-thin?
На Proxmox сначала получают корректный блочный доступ на каждом узле: storage-сети, сессии, один multipath-девайс с нужным WWID и ожидаемое число путей. Затем подключают хранилище к уровню Proxmox. Начинать с галочки Shared, когда хосты ещё видят разные устройства или часть путей отсутствует, неправильно: эта галочка не исправляет физическую связность.
Обычный LVM поверх общего iSCSI LUN и LVM-thin — разные backend. LVM-thin pools нельзя совместно использовать нескольким узлам так, как если бы это было обычное общее storage. Тонкое выделение места на PowerStore не делает тонкий пул внутри хоста автоматически кластерным. Нужно различать thin provisioning массива и механизм размещения виртуальных дисков гипервизора.
Флаг Shared сообщает платформе о принятом устройстве хранения; он не создаёт распределённую блокировку для произвольного содержимого. Для общего LVM используется поддерживаемая схема управления Proxmox, а операции вне неё нужно отдельно согласовывать. На всех узлах проверяют одинаковый базовый LUN, актуальное состояние VG и корректные фильтры устройств, чтобы LVM не выбирал одновременно отдельный путь и multipath-устройство.
Возможности снимков тоже зависят от версии. В Proxmox VE 9 появились снимки как цепочки томов для соответствующего LVM-сценария. Поэтому старое утверждение «у LVM никогда не бывает снимков» уже слишком общее. Однако это не отменяет ограничений LVM-thin и не делает все варианты хранения взаимозаменяемыми. В ТЗ фиксируют версию, backend, поддержку snapshots/clones и способ резервного копирования.
Проверка заканчивается миграцией тестовой ВМ между узлами, её запуском после перезагрузки хоста и контролируемым отказом storage-пути. Если используете сторонний CSI-плагин или другую интеграцию с PowerStore, проверьте её собственные ограничения. Успешная демонстрация стандартного LVM не подтверждает совместимость любого дополнительного компонента.
Когда в ESXi нужен iSCSI port binding, а когда он мешает?
Port binding software iSCSI предназначен для определённой сетевой модели. Если несколько iSCSI VMkernel-интерфейсов находятся в одной подсети и broadcast domain, привязка позволяет корректно организовать пути при соблюдении требований к vSwitch и физическим uplink. Это не универсальная кнопка «включить отказоустойчивость» для любой iSCSI-сети.
В схеме с разными подсетями A/B нельзя автоматически повторять binding из одноподсетного примера. Для выбранных ESXi 7.x/8.x правила прямо различают эти случаи. Ошибочная привязка приводит к попыткам соединения с недостижимыми комбинациями порталов, долгому rescan и неправильному числу путей. Если раньше такая конфигурация как будто работала, обновление может выявить её недостатки.
На каждом storage VMkernel проверьте исходный адрес, VLAN, MTU и соответствующий физический uplink. Настройки teaming для software iSCSI должны отвечать требованиям выбранного способа multipathing. Поддержка LACP на PowerStore не означает допустимость произвольного LACP на хостовом vSwitch. Эти ограничения находятся на разных концах соединения.
Практическая проверка включает таблицу маршрутов VMkernel, доступность порталов от конкретного vmk, число устройств и путей, ALUA-состояния и соответствие политики выбора пути. После этого проводят rescan, миграцию и перезагрузку в согласованном порядке. В конфигурации VMware используется один программный iSCSI-адаптер; дополнительные VMkernel-интерфейсы и пути не требуют создавать ещё один такой адаптер.
В проекте с более новым релизом гипервизора повторно проверяют применимость этих условий и матрицу Dell. Особенно важно не переносить ограничения только по номеру старой версии ESXi и не угадывать новое поведение. Версия storage-стека должна быть частью паспорта, наравне с версией NX-OS и PowerStoreOS.
Какая скорость нужна для PowerStore: 10, 25 или 100GbE?
Выбор скорости начинается с нагрузки на конкретный участок. Для серверной NIC это поток данного хоста, для порта массива — потоки хостов, приходящие в этот порт, для межкоммутаторной связи — только трафик, который действительно её пересекает. Суммарная производительность всех портов Cisco не отвечает на вопрос, выдержит ли один оставшийся путь нагрузку после отказа.
| Скорость линии | Теоретический предел в десятичных ГБ/с | О чём помнить |
|---|---|---|
| 10 Гбит/с | 1,25 ГБ/с | Полезная скорость ниже из-за протокольных расходов и условий обработки |
| 25 Гбит/с | 3,125 ГБ/с | Один путь не превращается в 6,25 ГБ/с из-за наличия резервной NIC |
| 100 Гбит/с | 12,5 ГБ/с | Нужны соответствующие возможности хоста, PCIe, массива и среды |
Эти значения получены делением битовой скорости на восемь. Они не являются обещанием скорости чтения файлов или базы данных. Полезный результат зависит от размера I/O, параллелизма, CPU, работы памяти, реализации драйвера, очередей и массива. Перевод в ГиБ/с даст другие числа, потому что ГБ и ГиБ используют разные основания.
Для умеренной нагрузки может хватать 10GbE, но при обновлении массива нужно проверить пиковые и аварийные режимы. 25GbE даёт больше пространства для параллельной работы и роста, а 100GbE рассматривают там, где это подтверждено расчётом потоков и возможностями фронтенда. Детальное сравнение самих коммутаторов вынесено в руководство по выбору Cisco для серверов и СХД. Здесь скорость — один из параметров целой цепочки доступа.
Как перевести IOPS и размер блока в сетевую нагрузку?
Для оценки полезного потока используют формулу: IOPS × размер блока в байтах × 8 = бит/с. Если выполняются 100 000 операций в секунду по 8 КиБ, получается 100 000 × 8192 × 8 = 6 553 600 000 бит/с, или около 6,55 Гбит/с. В расчёте нет TCP/IP, Ethernet и дополнительных команд. Это нижняя оценка необходимого полезного потока.
| Профиль | Полезный поток | Вывод для одной линии 25G |
|---|---|---|
| 100 000 IOPS × 8 КиБ | Около 6,55 Гбит/с | По порядку величины укладывается; проверяются накладные расходы и задержка |
| 200 000 IOPS × 8 КиБ | Около 13,11 Гбит/с | Запас меньше; важна одновременная нагрузка других ресурсов |
| 400 000 IOPS × 8 КиБ | Около 26,21 Гбит/с | Уже превышает скорость линии до учёта протоколов |
| 20 000 IOPS × 128 КиБ | Около 20,97 Гбит/с | Небольшое число IOPS может почти занять 25G из-за крупного блока |
Для смешанного профиля чтение и запись считают по своим размерам блоков. Не складывайте все операции так, будто они обязательно идут через один физический интерфейс в одном направлении. Нужно знать размещение томов, исходные хосты, направления потока и ALUA-предпочтения. Два тома с разной привязкой к узлам могут нагружать порты иначе, чем один большой том.
Число IOPS массива из теста с блоком 4 КиБ нельзя использовать для обещания скорости рабочего потока по 128 КиБ. Аналогично, последовательная передача большого файла не характеризует задержку мелкой синхронной записи. В ТЗ полезно иметь несколько профилей и прикладной тест, а не единственную строку «не менее N IOPS» без условий.
Как считать нагрузку после потери сети A или одного узла СХД?
Допустим, полезный поток через рассматриваемый участок составляет 1,6 ГБ/с клиентского I/O и ещё 0,8 ГБ/с репликации или другой нагрузки, которая действительно использует тот же участок. Сумма — 2,4 ГБ/с, то есть 19,2 Гбит/с. Если после отказа остаётся одна линия 25G, номинальная скорость ещё выше потока, но запас уже ограничен.
Предположим, проектом принят эксплуатационный ориентир 70% скорости линии. Тогда бюджет равен 17,5 Гбит/с, и поток 19,2 Гбит/с в него не укладывается. Это не означает, что Ethernet автоматически отключится при 70%. Проект просто не выполняет выбранное условие по запасу, которое нужно пересмотреть или обеспечить другим способом.
Возможные действия: развести репликацию и клиентский I/O, ограничить фоновые задания, увеличить пропускную способность оставшегося пути либо согласовать меньшую нагрузку аварийного режима. Решение должно соответствовать требованиям к приложению и защите данных. Например, бесконечно откладывать репликацию ради быстрого I/O нельзя, если это нарушает допустимое отставание копии.
Отказ узла массива меняет не только число портов. I/O может перейти к другому узлу, изменятся оптимизированные пути и нагрузка на его ресурсы. Поэтому тест «кабель из одного порта вынули, всё осталось доступно» не заменяет проверку отказа узла. Для каждого сценария отдельно строят оставшуюся топологию и считают её узкие места.
При анализе full-duplex Ethernet входящий и исходящий потоки рассматривают раздельно. Линия 25G может одновременно передавать и принимать данные; складывать оба направления и сравнивать сумму с 25 Гбит/с как с общим двусторонним пределом некорректно. Но внутри каждого направления общие очереди и конкуренция потоков сохраняются.
Почему высокая скорость не гарантирует низкую задержку?
Для приложения важны время ожидания и разброс задержек. Быстрая сеть может простаивать, пока запрос ждёт свободный слот в очереди хоста или обработку на массиве. Слишком большая очередь позволяет держать больше операций одновременно, но при насыщении увеличивает время ответа. Поэтому сравнивают производительность вместе с задержкой, а не выбирают максимальное число IOPS любой ценой.
Полезна простая оценка по закону Литтла: среднее число одновременно обслуживаемых запросов равно интенсивности потока, умноженной на среднее время в рассматриваемой системе. При 100 000 IOPS и 0,8 мс это примерно 80 запросов. При той же интенсивности и 1,6 мс — 160. Это оценка для согласованного участка и устойчивого режима, а не готовое рекомендуемое значение queue depth.
Если увеличить глубину очереди, когда контроллер уже насыщен, приложение может получить больший хвост задержек без заметного выигрыша в полезной работе. Если очередь слишком мала, часть ресурсов останется недогруженной. Настройки выбирают вместе с поддержкой массива, HBA/NIC и ОС, затем проверяют на нужном профиле.
В отчёте показывают среднюю задержку, p95/p99 и длительность отдельных пауз при отказе. Процентиль нужно относить к определённым измерениям: дисковым операциям, сетевому RTT или прикладным транзакциям. Это разные показатели. Ping с RTT меньше миллисекунды не доказывает такую же задержку синхронной записи в базу данных.
Зачем смотреть очереди, микровсплески и счётчики потерь Cisco?
Потоки от нескольких серверов могут на короткое время одновременно попасть в один выходной порт. Средняя загрузка за пять минут выглядит умеренной, а выходная очередь уже теряет пакеты во время всплеска. Для TCP это означает повторные передачи и изменение скорости, а для storage-приложения — возможный рост задержки.
Буфер помогает пережить короткое превышение входящего потока над скоростью выхода. Он не заменяет пропускную способность для длительной перегрузки. Например, условные 10 МБ дополнительного буфера при избытке входящего трафика 10 Гбит/с заполнятся примерно за 8 мс: 10 000 000 × 8 / 10 000 000 000. Это расчётный пример, а не характеристика конкретного Nexus.
Снимайте счётчики на том интерфейсе и в том направлении, где концентрируется поток. Полезно сопоставлять выходные discards, ошибки физического уровня, retransmits на хосте и задержку тома на PowerStore. Если все значения относятся к разным временным окнам, причинную связь установить трудно. Синхронизация времени и отметки начала теста упрощают анализ.
Выбор коммутатора только по сумме скоростей портов оставляет эти вопросы без ответа. В storage-сети нужны подходящий профиль нагрузки, предсказуемое поведение очередей и наблюдаемость. До закупки определите, какие показатели можно получить с выбранной модели и версии ПО, чтобы после установки не выяснилось, что необходимый счётчик недоступен или имеет другое значение.
Нужно ли включать QoS, flow control, PFC или RDMA для iSCSI?
Обычный iSCSI работает поверх TCP и не требует RDMA только по факту использования быстрого массива. Global pause, PFC и механизмы управления перегрузкой решают разные задачи. Их наличие в коммутаторе не означает, что они должны быть включены для всех storage-портов.
Global pause способен приостанавливать передачу на линии и затрагивать потоки, которые сами не создавали проблему. PFC работает с приоритетами, но требует согласованной модели классификации и обработки перегрузки. Ошибочная настройка добавляет зависимости и может переносить задержку на другие участки. Поэтому нельзя лечить любые discards включением всех доступных механизмов.
Если сеть общая для storage, репликации и пользовательского трафика, полезно определить бюджет и приоритеты каждого класса. Ограничение фонового задания иногда даёт предсказуемый результат проще, чем сложная политика очередей. Но приоритет не создаёт дополнительной полосы: при перегрузке кому-то всё равно придётся ждать или терять пакеты.
Сначала соберите измерения, затем выберите механизм и проверьте его поддержку на обоих концах. Меняют один обоснованный параметр или связанный набор, сохраняя прежние значения и тестовую методику. Если после настройки средняя скорость выросла, а p99 приложения ухудшился, считать изменение удачным преждевременно. В ТЗ должны присутствовать оба критерия.
Как защитить iSCSI: VLAN, ACL, CHAP и административный доступ
Сеть хранения ограничивают по участникам. Сервер должен видеть нужные порталы, а пользовательские рабочие станции не должны получать такой же доступ только потому, что знают IP массива. VLAN помогает разделить сегменты, но сам по себе не описывает все разрешённые соединения. Дополнительно согласуют ACL, маршрутизацию и доступ к управлению.
CHAP используется для аутентификации, но не шифрует передаваемые блоки данных. Если требуется конфиденциальность трафика на линии, нужен отдельно поддерживаемый механизм защиты. Наличие пароля в настройках initiator нельзя выдавать за шифрование storage-потока. Шифрование данных на накопителях тоже решает другую задачу.
Административные учётные записи СХД и Cisco отделяют от обычного доступа к томам. Предусматривают журналирование, ограниченный вход, управление секретами и проверяемый аварийный доступ. Общая учётная запись, известная всем подрядчикам, усложняет контроль изменений и расследование. Секреты не включают в открытые схемы и отчёты испытаний.
Host mapping должен давать доступ только нужным инициаторам. Удалённый или переустановленный сервер проверяют на оставшиеся сопоставления. Группы хостов создают по реальной совместной работе с данными, а не для удобства «показать всё всем». Эти меры защищают и от случайной ошибки: неверно сопоставленный том можно повредить быстрее, чем возникнет заметный сетевой инцидент.
Защищают ли два Cisco и multipath от потери данных?
Multipath повышает доступность соединения при предусмотренных отказах. Он не создаёт историческую резервную копию и не отменяет ошибки приложения. Если удаление или повреждение корректно записалось в том, все рабочие пути будут вести к тому же изменённому состоянию. Больше кабелей не добавляет возможность вернуться к вчерашним данным.
Репликация и снимки полезны, но их роль нужно описать отдельно. Реплика может воспроизвести ошибочное изменение. Снимок зависит от выбранной модели защиты, сохранности массива и прав доступа. Для критичных систем согласуют независимую копию и проверяют восстановление в ситуации, когда основной storage-контур недоступен.
План восстановления должен учитывать зависимости. Где находится каталог пользователей, DNS, менеджер виртуализации и сервер копирования? Можно ли войти в управление массивом и развернуть первый сервис, если сам кластер остановлен? Какие секреты и конфигурации понадобятся? Ответы записывают до аварии и проверяют на тестовом запуске.
RPO измеряют по фактической свежести восстановленных данных, RTO — по готовности сервиса. Время, за которое том снова появился в ОС, полезно для диагностики, но не заменяет эти показатели. Если база восстанавливает журнал ещё несколько минут после возвращения диска, это время входит в прикладной результат.
Как составить программу приёмочных испытаний?
Испытания начинаются с тестового тома и понятного профиля нагрузки. Зафиксируйте чтение/запись, размер блока, параллелизм, длительность и набор контролируемых прикладных операций. Короткий тест из кэша может почти ничего не сказать о длительной записи, восстановлении после отказа и заполненном массиве. Методика должна соответствовать тому, что предстоит эксплуатировать.
Перед отказами сохраните исходное состояние: матрицу путей, ALUA, версии, сетевые счётчики и нормальную задержку. Назначьте ответственного, критерий остановки и способ возврата. В рабочем контуре такие проверки проводят в согласованное окно с защищёнными данными; тестовая схема не является разрешением отключать производственное оборудование без подготовки.
| Тест | Ожидаемая проверка | Что записать |
|---|---|---|
| Потеря одной линии хоста | Путь исчез, оставшиеся обслуживают том | Исходные/целевые IP, время реакции, ошибки I/O |
| Потеря одной NIC | Сохраняется путь через другой адаптер | Физическая независимость и оставшаяся скорость |
| Потеря Cisco A | Доступ через сеть B к нужным узлам СХД | Пути, задержка, загрузка оставшихся интерфейсов |
| Отказ storage-порта | Корректное изменение путей к тому | Сессии, ALUA и прикладная пауза |
| Обслуживание узла СХД | Поддерживаемое переключение обслуживания тома | Реакция хоста, доступность и время стабилизации |
| Перезагрузка хоста | Сессии и multipath восстановились автоматически | Идентификатор тома и полный набор путей |
| Возврат компонента | Путь вернулся без нежелательного перезапуска приложения | Повторные переключения, ошибки и новая нагрузка |
| Восстановление копии | Работоспособность сервиса и целостность данных | Фактические RPO/RTO, зависимости и результат проверки |
Критерий «нет непредусмотренных ошибок записи» не означает, что в журналах не должно быть ни одного сообщения о потерянном пути. Сообщение о правильно обнаруженном отказе ожидаемо. Нужно отличать штатную реакцию storage-стека от потери тома и ошибки, которую увидело приложение. Этот разбор требует синхронных журналов хоста, СХД и Cisco.
Какие таймеры влияют на переключение и почему нельзя ставить их наугад?
При отказе участвуют несколько механизмов: обнаружение потери физического линка, TCP-повторные передачи, проверка пути, SCSI-таймеры, политика multipath и ожидание приложения. Некоторые работают последовательно, другие параллельно. Поэтому время реакции не равно одному параметру из multipath.conf или одной настройке MPIO.
Слишком длинное ожидание всех путей может удерживать операции до момента, когда кластерное приложение уже признало ресурс неработоспособным. Слишком короткое — вернуть ошибку до завершения допустимого переключения. Нужно согласовать поведение storage-стека и приложения, затем проверить его по временной шкале отказа.
В Linux отдельно рассматривают queue_if_no_path и конечное число повторов. Бесконечная очередь может удерживать процессы, пока путь не вернётся. Это иногда принимают за зависание ядра или самой базы, хотя первопричина находится в доступности хранилища. Менять политику во время инцидента следует с пониманием последствий для незавершённых операций, а не копировать случайную команду отключения очереди.
Для Windows и гипервизоров также важны поддерживаемые DSM, политика восстановления и постоянство соединений. Точные значения сохраняют вместе с версиями. Если обновление изменяет рекомендации, сначала проверяют новый набор на пилоте. Хороший проект содержит объяснение выбора таймеров и измеренную паузу, а не только список чисел без контекста.
Почему возврат пути проверяют отдельно от его отказа?
После возвращения кабеля или узла система снова меняет состояние. Возобновляются сессии, обновляются группы путей, может измениться распределение I/O. Если порт нестабилен и многократно поднимается и падает, автоматический возврат иногда создаёт больше помех, чем первоначальная потеря одного устойчивого пути.
Сначала убедитесь, что физическая причина устранена: нет новых ошибок, FEC соответствует режиму, оптика и соединение стабильны. Затем наблюдайте, вернулся ли ожидаемый путь и что произошло с задержкой приложения. Формальное появление строки active ещё не гарантирует, что трафик распределяется как предусмотрено.
Не обнуляйте все журналы до того, как сопоставлены события отказа и возврата. Сохранённые исходные счётчики помогают увидеть, где началась проблема. Если после обслуживания путь вернулся с другой скоростью или через другой интерфейс, это нужно исправить и повторить соответствующий тест, даже когда том уже доступен.
В итоговом протоколе отдельно отмечают время отказа, время обнаружения, начало работы по резерву, возврат компонента и завершение стабилизации. Такой отчёт позволяет сравнить поведение после обновления драйвера, firmware или NX-OS. Повторяемая методика полезнее единичного результата «ничего не заметили» без измерений.
Сервер видит портал, но не видит LUN: где искать причину?
Разделите проблему на этапы. Сначала проверьте достижимость IP-портала от правильного источника. Затем — доступ к TCP 3260 и результат discovery. После этого смотрят login-сессию, IQN, аутентификацию и сопоставление тома. Только когда все эти уровни подтверждены, имеет смысл разбирать распознавание диска операционной системой или гипервизором.
Если discovery проходит, но login не устанавливается, проверьте идентичность initiator и параметры доступа. Если login есть, а нужного тома нет, сравните host mapping, группу хостов и ID ресурса на PowerStore. Если устройство видно на одном хосте и не видно на втором, разница может находиться в регистрации второго IQN, его исходном интерфейсе или конфигурации storage-стека.
Для сетевой части полезно записать конкретную неработающую пару: например, 10.30.120.12 → 10.30.120.102:3260. Такая запись гораздо полезнее сообщения «не работает multipath». По ней можно проверить путь через Cisco B, нужный VLAN и целевой порт узла 2, не меняя исправную сеть A.
Не создавайте новый том и не инициализируйте незнакомый диск как метод диагностики. Rescan должен обнаруживать существующую конфигурацию, а не подменять проверку сопоставления. Если том уже содержит данные, сохраните его идентификаторы и владельца ресурса до любых действий. Причина отсутствия диска часто находится выше или ниже массива, и повторное создание storage только усложнит восстановление.
Почему обнаружились два пути вместо четырёх?
Два пути могут означать разные вещи: работает только одна сеть, доступен только один узел СХД, созданы не все сессии или часть устройств не распознана multipath-стеком. Чтобы различить эти случаи, сопоставьте каждый путь с исходным адресом, порталом и узлом массива. Само число «два» не даёт диагноза.
Если оба пути используют 10.30.110.x, сначала разбирайте сеть B и исходные настройки хоста. Если пути есть через A и B, но оба ведут к одному узлу, проверьте порталы второго узла и назначение тома. Если все сессии установлены, а multipath показывает только часть устройства, переходите к claim-политике, WWID, фильтрам и поддерживаемой конфигурации ОС.
После исправления выполните контролируемый rescan и сравните новую матрицу с исходной. Затем подтвердите, что путь действительно используется или готов к переключению. Не добавляйте несколько одинаковых сессий от одного адреса к одному порталу только ради нужного количества строк. Это создаст видимость исправления, сохранив прежнюю физическую зависимость.
Обратная ситуация — путей больше ожидаемого — тоже требует разбора. Причиной бывают повторная конфигурация discovery, лишние target-порталы или одновременное использование старого и нового метода подключения. Установите происхождение каждой строки и удаляйте лишнее только по согласованному плану, сохранив рабочий доступ к тому.
Почему iSCSI работает медленно, хотя Cisco показывает свободную полосу?
Низкая средняя загрузка сети не исключает задержку на одном потоке, микровсплески или ограничение хоста. Начните с профиля теста: размер блока, число потоков, глубина очереди, чтение/запись, прямой I/O и длительность. Сравнивать два результата можно только при сопоставимых условиях. Тест из файлового кэша не измеряет то же самое, что синхронная запись на том.
Затем локализуйте участок ожидания: приложение, виртуальный диск, очередь гипервизора, NIC, сеть, target-порт или сам массив. На сервере смотрят загрузку CPU, распределение прерываний, retransmits и состояние очередей. На Cisco — ошибки и выходные потери. На PowerStore — задержку и нагрузку тома, узлов и интерфейсов.
Если медленно работает один том, а соседние тома на тех же хостах нормальны, проверьте их разницу: привязку к узлу, профиль записи, размещение данных и конкурирующие задачи. Если одновременно замедлились все хосты одной сети, общий компонент становится более вероятным кандидатом. Но совпадение по времени ещё нужно сопоставить с журналами и измерениями.
Меняйте параметры по проверяемой гипотезе. Одновременное увеличение очередей, MTU и числа сессий может случайно улучшить тест, но не объяснит причину. Для эксплуатации полезнее знать границу и воспроизводимый способ её измерить. Сохраните контрольный профиль, чтобы после изменения можно было сравнить не только скорость, но и хвост задержек.
Что делать, если один том виден как несколько дисков?
Сначала подтвердите, что устройства имеют одинаковый постоянный идентификатор и являются путями к одному ресурсу. Совпадение размера недостаточно: два разных тестовых тома вполне могут иметь одинаковую ёмкость. Сопоставьте WWID или серийный номер с ID тома PowerStore и матрицей сессий.
Если это действительно разные пути одного тома, проверьте MPIO/DM-Multipath и политику захвата устройства. На Linux дополнительно смотрят, не видит ли LVM одновременно отдельные sdX и объединённый mapper-девайс. На Windows сравнивают список MPIO-дисков и используемый DSM. Исправление должно привести к одному логическому устройству с несколькими управляемыми путями.
Не форматируйте каждый обнаруженный экземпляр. Запись файловой системы в один «диск» в такой ситуации меняет данные того же тома, который виден по остальным путям. Если ресурс уже использовался, сначала остановите несогласованные операции записи и разберите владельца данных. В производственном контуре действия выполняют по процедуре восстановления, а не экспериментом с разметкой.
После исправления проверьте постоянство имён и поведение после перезагрузки. Правильная конфигурация должна воспроизводиться автоматически. Ручной выбор «того диска, который сейчас первый в списке» не подходит для скриптов, мониторинга и регулярного обслуживания.
Как обновлять Cisco, PowerStore и драйверы без потери резервирования?
Перед обновлением убедитесь, что резерв действительно работоспособен. Если одна сеть уже потеряла часть путей, обслуживание второй может превратить плановую работу в полную потерю доступа. Состояние системы перед изменением должно быть проверенным, а не просто считаться нормальным из-за отсутствия жалоб.
План включает поддерживаемую последовательность версий, исходные настройки, окно, критерий остановки и возврат. Отдельно проверяют требования к firmware/драйверу NIC и поддержке массива. Установка самого нового драйвера не всегда равна установке рекомендованного сочетания для выбранного гипервизора.
Обновление выполняют по очереди в пределах предусмотренных доменов отказа. Нельзя одновременно обслуживать Cisco A и единственный оставшийся путь сети B, даже если это разные задачи разных подрядчиков. Общий календарь работ и единая схема зависимостей нужны именно для предотвращения таких совпадений.
После каждого этапа проверяют восстановление всех путей, версии, скорость линков, ошибки и контрольный I/O-профиль. Если система вернулась в доступное, но деградированное состояние, следующий этап откладывают до выяснения причин. Закрыть изменение можно после подтверждённого возврата полного предусмотренного резерва, а не только после завершения процедуры установки ПО.
Как расширять тома и переносить данные между конфигурациями?
Расширение состоит из нескольких слоёв: увеличение ресурса на СХД, обнаружение нового размера хостом, обновление multipath-устройства, изменение менеджера томов и файловой системы или datastore. Возможности и порядок зависят от ОС. Успешное изменение размера на PowerStore не означает, что верхний слой уже может использовать всё пространство.
Для общего тома согласуйте владельца операции и видимость на остальных узлах. После расширения проверяют одинаковый ID, новый размер и нормальное состояние всех путей. Не создавайте новый независимый диск поверх одного из путей старого ресурса. Перед изменением полезно сохранить исходную карту слоёв и подтверждённую резервную копию.
Перенос с Fibre Channel на iSCSI или с iSCSI на NVMe/TCP рассматривают как миграцию. Нужно проверить поддержку выбранного метода, порядок отключения старого доступа и включения нового, идентичность ресурса, представление его хосту и возможность возврата. Одновременное подключение одного тома разными протоколами к тому же хосту не является универсальным способом сделать миграцию бесшовной.
При замене самих Cisco сначала воспроизведите необходимые VLAN, MTU и роли портов на новом оборудовании, затем проверьте тестовый путь. Перенос выполняют контролируемыми группами соединений. Если одновременно меняются адресация, гипервизор и массив, разделите этапы, чтобы в случае ошибки можно было определить её источник и вернуться к известному состоянию.
Для переноса приложения отдельно планируют согласованность данных. Копия тома, сделанная во время записи, не всегда равна готовой копии базы. Учитывают журналы, порядок остановки сервисов, момент переключения пользователей и проверку целостности после запуска. Сетевой успех миграции заканчивается только тогда, когда приложение и его резервное копирование работают в новой конфигурации.
Сколько портов, кабелей и модулей заказать для трёх хостов?
Вернёмся к основному примеру. На каждом из трёх хостов используются два отдельных 25G-подключения, одно в A и одно в B. У каждого из двух узлов PowerStore также есть по одному целевому подключению в каждую сеть. Итого шесть хостовых линий и четыре линии массива — десять линий 25G.
| Позиция | Количество | Что проверить |
|---|---|---|
| Хостовые линии | 3 × 2 = 6 | При необходимости отказоустойчивости карты — распределение по двум NIC |
| Целевые линии PowerStore | 2 узла × 2 сети = 4 | Порталы обоих узлов в каждом контуре |
| 25G-порты Cisco A | 3 хоста + 2 узла СХД = 5 | Дополнительно резерв расширения и другие роли |
| 25G-порты Cisco B | 3 хоста + 2 узла СХД = 5 | Те же требования к полной нагрузке после отказа A |
| Оптические модули, если все 10 линий на оптике | 20 | По два на линию, совместимые с обоими концами |
| DAC, если все 10 линий выполнены подходящими DAC | 10 сборок | Отдельные парные трансиверы к этим сборкам не добавляют |
| iSCSI-пути к одному тому | По 4 на хост | Это логические пути, а не ещё 12 физических кабелей |
Административные подключения, NAS, репликация, кластерные связи нескольких массивов и uplink в эти десять линий не включены. Их считают отдельно. При шести хостах базовая storage-часть займёт по восемь портов каждого Cisco; при двенадцати — по четырнадцать, если число target-подключений остаётся прежним. Расширение портов хостов не увеличивает автоматически пропускную способность фронтенда массива.
Например, Cisco N9K-C93180YC-FX3 имеет 48 портов 1/10/25G SFP28 и шесть 40/100G QSFP28. Для небольшого проекта это не означает необходимость занимать все порты или преимущество над любым другим подходящим вариантом. Оценивают весь состав, функции, поддержку, энергопотребление и план роста.
При сравнении Dell PowerStore 1200T и Dell PowerStore 3200T проверяйте конкретные интерфейсные модули и релиз. Эти модели с обозначением T не следует называть новым Gen 3 только из-за возможности обновления ПО. Состав заказа должен однозначно показывать, какой именно массив, модули и кабели будут поставлены.
Как сравнить коммерческие предложения Cisco и Dell по одному ТЗ?
Сравнивайте комплекты, которые решают одинаковую задачу. В одном предложении могут отсутствовать трансиверы, второй адаптер, лицензия поддержки, кабели управления или испытания. Тогда разница цены базовых устройств не показывает разницу стоимости готового подключения. Запрос должен содержать перечень ролей и ожидаемые результаты приёмки.
По серверной и storage-части можно обратиться на официальный сайт Dell в России, передав матрицу хостов, требования к интерфейсам и выбранную версию платформы. Для Cisco передают тот же адресный план, числа портов и сценарии отказа. Участникам проекта нужно согласовать границу ответственности: кто проверяет совместимость, кто собирает конфигурацию и кто подтверждает работу приложения.
В стоимость владения включают поддержку и обновления, запасные кабели и модули, мониторинг, время обслуживания и миграцию. Экономия на одном соединении может означать отказ от конкретного сценария резервирования; это должно быть явным решением. С другой стороны, сложная агрегация без нужды тоже увеличивает время настройки и сопровождения. Полезен минимальный состав, который проходит реальные требования и допускает понятное расширение.
Как выглядит пилот одного тома: пример протокола без догадок по числу путей
Возьмите отдельный тестовый том с записанным ID и набором проверочных данных. На первом хосте должны появиться четыре пути из нашей матрицы. Сохраните фактические исходные адреса и порталы, а не только общее число. Для каждого пути укажите Cisco, физическую NIC, узел СХД и состояние ALUA. На этом шаге уже можно обнаружить, что две якобы разные строки используют один порт.
Предположим, том имеет привязку к узлу 1. Через A и B к нему есть два оптимизированных пути, к узлу 2 — два неоптимизированных. Это условное начальное состояние для примера; его подтверждают на реальном томе. После смены привязки распределение может стать другим, поэтому фиксировать в инструкции «первые две строки всегда оптимизированы» нельзя.
| Состояние примера | Ожидаемые доступные маршруты | Что требуется подтвердить |
|---|---|---|
| Оба Cisco и оба узла доступны | Четыре пути: по два через A и B | Один WWID, оба узла, правильные ALUA-группы |
| Сеть A недоступна | Два пути через B к обоим узлам | Продолжение I/O и приемлемая оставшаяся производительность |
| Сеть A восстановлена | Снова четыре пути после стабилизации | Нет повторяющегося flap и незапланированных ошибок приложения |
| Узел 1 обслуживается по поддерживаемой процедуре | Доступные пути к узлу 2 через обе сети | Корректное изменение обслуживания тома и реакция хоста |
| Узел 1 вернулся | Полный предусмотренный набор путей | Идентичность тома, новая ALUA-картина и стабильный профиль I/O |
Каждый следующий отказ начинают после восстановления согласованного исходного состояния. Если после первого теста осталось три пути вместо четырёх, не переходите сразу к обслуживанию другого элемента. Сначала разберите деградацию. Иначе проверка второго одиночного отказа фактически станет испытанием комбинации неисправностей, для которой условия ещё не согласованы.
Полезно разделить наблюдения по времени. В момент T0 отмечают штатное состояние. В T1 выполняют предусмотренное действие. Затем фиксируют обнаружение потери пути, изменение I/O, реакцию приложения и установившуюся нагрузку. При возврате создают новую отметку. Время берут из согласованных часов; перепутанные часовые пояса в журналах способны создать ложную последовательность событий.
На каждом этапе выполняйте одну и ту же прикладную операцию и проверку контрольных данных. Результат storage-теста должен связываться с работой сервиса. Если операционная система показывает доступный том, но приложение застряло на собственной повторной попытке, это отдельная проблема, которую нужно включить в отчёт и критерии восстановления.
После первого хоста повторите необходимые проверки на втором и третьем. Общий шаблон конфигурации снижает трудозатраты, но не доказывает одинаковую физическую разводку. Ошибка одного патч-корда или другой firmware NIC может существовать только на одном сервере. Завершённый пилот даёт проверенный шаблон, список исключений и измерения для последующего расширения.
Что контролировать после запуска, чтобы резерв не исчез незаметно?
Мониторинг должен замечать деградацию раньше жалобы на недоступный диск. Для каждого хоста полезны ожидаемое и фактическое число путей, их состояние, доступность порталов, перезапуски сессий и ошибки I/O. Отдельно наблюдают физические ошибки NIC и Cisco, загрузку портов, задержку томов и события PowerStore. Один общий индикатор «СХД доступна» не показывает, что осталось от резервирования.
Порог определяется моделью, а не случайным универсальным числом. В нашем четырёхпутевом примере потеря одного пути уже является отклонением, даже когда приложение продолжает работать. Но автоматизация должна учитывать согласованные окна обслуживания, чтобы сообщения оставались полезными. В событии желательно видеть хост, WWID, исходный адрес и целевой портал — это сокращает время локализации.
Сохраняйте историю нагрузки и задержки в сопоставимых интервалах. После добавления новых ВМ или томов сравнивайте не только общий поток, но и распределение по узлам и порталам. Суммарный I/O может вырасти умеренно, а один оптимизированный путь — приблизиться к насыщению из-за нового расположения данных.
Планируйте периодическую проверку восстановления, а также повторный тест после существенных изменений. Частоту выбирают по важности сервиса и принятому процессу обслуживания. Нет необходимости имитировать аварии ежедневно; необходимо знать, что драйвер, firmware, новая NIC или изменённая адресация не отменили свойства, за которые кластер был принят.
Передавайте эксплуатационной команде не только пароль и схему стойки. Нужны ожидаемая матрица, контрольный профиль, перечень версий, контакты ответственных и способ собрать журналы. Тогда первый специалист сможет отличить единичный потерянный путь от общей потери storage и не будет предпринимать опасную переинициализацию устройства ради восстановления доступа.
Частые вопросы о Dell PowerStore, Cisco Nexus и iSCSI
Нужен ли серверу Dell фирменный коммутатор Dell?
Нет общего требования использовать один бренд во всей цепочке. Dell PowerStore и серверные инициаторы могут работать через подходящую сеть Cisco. Совместимость относится к конкретным интерфейсам, модулям, ПО и архитектуре. Смешение брендов само по себе не создаёт проблему, но не освобождает от проверки поддержки и согласованного проекта. Более подробно вам могут рассказать инженеры официального поставщика Dell в России.
Можно ли подключить PowerStore к обычному Catalyst?
Оценивают возможности точной модели: скорости, профиль портов, очереди, MTU, наблюдаемость и поддержку архитектуры. Название Catalyst не даёт универсального ответа. Для производительной серверной сети часто рассматривают Nexus, но выбирать нужно по требованиям. Коммутатор офисного доступа с подходящим разъёмом может оказаться ограничением в storage-сценарии.
Обязательно ли соединять два storage-коммутатора между собой?
Для отдельных iSCSI-сетей A/B существуют схемы с независимыми коммутаторами. При этом в каждой сети должен быть нужный доступ к хостам и узлам СХД. Если инфраструктура также обслуживает NAS или кластерные связи нескольких массивов, их требования рассматривают отдельно. Отсутствие ISL нельзя объявить универсальным правилом для всех PowerStore-развёртываний.
Почему одинаковые номера портов PowerStore иногда подключают к разным Cisco, а иногда к одному?
Это зависит от роли port pair, распределения сетей и наличия общей связи между коммутаторами. Схема независимых подсетей отличается от схемы растянутого VLAN или bond. Нельзя оценивать правильность по номеру порта вне архитектуры. Нужны назначение каждой пары и матрица достижимости при отказах.
Четыре пути означают четырёхкратную скорость?
Нет. Пути могут делить одну NIC, один порт массива, оптимизированный узел и другие ресурсы. ALUA также влияет на выбор маршрута. Количество путей характеризует доступность и варианты обслуживания, а скорость ограничивает вся цепочка. Её измеряют на нужном профиле и проверяют после потери части ресурсов.
Две NIC по 25G достаточно для любого PowerStore?
Такое количество может быть частью хорошего проекта, но не является универсальной гарантией. Нужно знать поток хоста и оставшуюся после отказа нагрузку. Если одному хосту требуется более 25 Гбит/с полезного I/O после потери одной линии, один оставшийся 25G-путь не выполнит это требование независимо от модели массива.
Можно ли использовать один VLAN для управления и iSCSI?
Некоторые допустимые схемы допускают совместную физическую инфраструктуру, но роли и адресация должны соответствовать требованиям релиза. Для эксплуатации обычно удобнее явное разделение доступа и трафика. Главное — не принимать совместный VLAN за защиту и не открывать storage-порталы всем устройствам административной сети без необходимости.
Нужно ли включать CHAP?
Решение зависит от принятой модели доступа и поддержки выбранной конфигурации. CHAP добавляет аутентификацию, но не заменяет сетевую изоляцию и не шифрует блоки данных. Настройки должны совпадать на обеих сторонах, а секреты — храниться безопасно и обновляться по управляемой процедуре.
Можно ли назначить один default gateway на обе storage-NIC?
В нашем примере локальные порталы доступны в собственных подсетях без такого шлюза. Для маршрутизируемой схемы нужен отдельный расчёт маршрутов и поддерживаемого поведения стека. Случайное дублирование default route может изменить исходящий интерфейс и создать асимметрию. Проверяйте конкретные пары source/target, а не только общую доступность адреса.
Достаточно ли ping, чтобы принять iSCSI-подключение?
Нет. Ping показывает ограниченную сетевую доступность в момент проверки. Дополнительно нужны login, mapping, идентичность тома, правильные пути и I/O. Даже крупный ping с запретом фрагментации не измеряет задержку записи и не подтверждает восстановление после отказа коммутатора или контроллерного узла.
Почему после reboot пропала половина путей?
Проверьте постоянство сессий, порядок старта сети и сервисов, сохранённые привязки инициатора и конфигурацию multipath. Возможно, часть подключений создавалась только вручную. Сравните исходные IP и порталы с паспортом. Плановая перезагрузка тестового хоста входит в приёмку именно для обнаружения таких зависимостей.
Можно ли назначить один IQN нескольким серверам?
Для независимых инициаторов нужна корректная уникальная идентичность. Случайное копирование IQN вместе с образом ОС затрудняет разграничение и сопоставление доступа. После клонирования хоста проверьте его initiator name, регистрацию на СХД и назначение томов. Имя сервера в интерфейсе управления не исправляет повторённый IQN.
Нужен ли отдельный iSCSI-адаптер ESXi для каждой сети?
Для software iSCSI используется один программный адаптер, к которому относится нужная конфигурация VMkernel и путей. Попытка создать несколько таких адаптеров не решает задачу двух подсетей. Нужно правильно организовать исходящие интерфейсы и применять port binding только в подходящей сетевой модели.
Можно ли просто пометить общий LVM-thin как Shared?
Нет. Этот флаг не меняет устройство backend и не добавляет безопасную координацию доступа. Для Proxmox различайте обычный общий LVM и локальный LVM-thin. Отдельно проверяйте версию и поддерживаемые функции снимков. Тонкое выделение пространства на СХД не отменяет ограничений хостового пула.
Когда имеет смысл перейти с iSCSI на NVMe/TCP?
Когда это подтверждено требованиями приложения, поддержкой массива и хоста, тестами и стоимостью перехода. NVMe/TCP использует собственные идентификаторы и multipath-модель. Замена протокола не исправляет ошибку VLAN или слабую NIC. Сначала найдите реальное ограничение, затем сравните поддерживаемые варианты на одинаковой нагрузке.
Нужен ли Cisco MDS для этого проекта?
Для обычного iSCSI через Ethernet — нет. Cisco MDS рассматривают в Fibre Channel SAN с соответствующими HBA, оптикой и фабриками. Ethernet Nexus и FC MDS решают разные задачи. Переход между ними — изменение архитектуры подключения, а не перестановка одного и того же кабеля в другой коммутатор.
Почему после замены массива стало больше задержек?
Проверьте изменившиеся условия: политику путей, ALUA, прошивки и драйверы, профиль тома, размер блока, очередь и фактические скорости портов. Новый массив может быстрее заполнять прежний сетевой путь. Сравнение должно опираться на контрольный профиль и одинаковые измерения, а не на ожидание улучшения от одного названия модели.
Что считать завершением настройки?
Сохранённую конфигурацию, подтверждённую матрицу путей, пройденные испытания отказов и возврата, восстановление сессий после reboot и работоспособность приложения. К результату добавляют понятный паспорт и способ повторить тест. Одного обнаруженного диска и успешной записи небольшого файла для этого недостаточно.
Что передать инженеру для подбора и внедрения?
Подготовьте перечень хостов и версий ОС, список NIC с firmware/драйверами, текущую модель и релиз PowerStore, конфигурацию Cisco и требования приложения. Добавьте пиковые IOPS и размер блока, полезный объём и рост, ограничения по задержке, допустимую паузу при отказе и план резервного копирования.
К запросу приложите схему A/B, адресную матрицу, существующие кабели и модули, роли занятых портов и перечень изменений. Отдельно укажите, планируются ли NAS, несколько appliances, Metro, смена гипервизора или протокола. Эти условия меняют архитектуру и не должны выясняться только во время монтажа.
В ответе ожидайте точную спецификацию, подтверждение совместимости для выбранных версий, схему соединений, параметры хостов, программу испытаний и границу ответственности. Тогда приёмка будет опираться на воспроизводимые результаты: нужный том, нужные пути, измеренная нагрузка и понятное поведение при отказе каждого предусмотренного компонента.